多线程和并发
2026-10-16 14:26:06 0 举报Java多线程知识点
运维
模板推荐
作者其他创作
大纲/内容
并发的三大特性
原子性
一操作或多操作同时成功或者失败
可见性
一个线程修改了数据,其他线程可见
有序性
按代码的执行顺序执行
指令重排:JVM为了程序的效率会将代码重排,单线程无影响 多线程有影响,避免使用Executors工具类创建
Executors 返回线程池对象的弊端如下:<br><br>FixedThreadPool 和 SingleThreadExecutor : 允许请求的队列长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致OOM。<br><br>CachedThreadPool 和 ScheduledThreadPool : 允许创建的线程数量为 Integer.MAX_VALUE ,可能会创建大量线程,从而导致OOM。<br>
自己使用时hreadPoolExecutor类创建线程池(7大参数)
十五种锁
公平锁/非公平锁
非公平锁
会造成优先级反转或者饥饿现象
Synchronized 是非公平锁
ReentrantLock默认是非公平锁 可以设置为公平锁
可重入锁/不可重入锁
ReentranLock和Synchroized都是可重入锁
独占锁/共享锁
ReentranReadWriteLock里的读锁 是共享锁
Synchronized是独享锁
互斥锁(排他锁)/读写锁
自旋锁与互斥锁都是为了实现保护资源共享的机制。<br>无论是自旋锁还是互斥锁,在任意时刻,都最多只能有一个保持者。<br>获取互斥锁的线程,如果锁已经被占用,则该线程将进入睡眠状态;获取自旋锁的线程则不会睡眠,而是一直循环等待锁释放。
互斥
互斥锁
lock、读写锁
无锁
线程本地存储
cas/unsafe
copy-on-write
Copy-On-Write简称COW,是一种用于程序设计中的优化策略。其基本思路是,从一开始大家都在共享同一个内容,当某个人想要修改这个内容的时候,才会真正把内容Copy出去形成一个新的内容然后再改,这是一种延时懒惰策略。从JDK1.5开始Java并发包里提供了两个使用CopyOnWrite机制实现的并发容器,它们是CopyOnWriteArrayList和CopyOnWriteArraySet。CopyOnWrite容器非常有用,可以在非常多的并发场景中使用到。
写加锁、读不加锁
CopyOnWrite并发容器用于读多写少的并发场景。比如白名单,黑名单,商品类目的访问和更新场景,假如我们有一个搜索网站,用户在这个网站的搜索框中,输入关键字搜索内容,但是某些关键字不允许被搜索。这些不能被搜索的关键字会被放在一个黑名单当中,黑名单每天晚上更新一次。当用户搜索时,会检查当前关键字在不在黑名单当中,如果在,则提示不能搜索。实现代码如下
每天晚上都更新,适合不用及时获取结果的场景
原子类
读写锁升降级
读锁->写锁->释放
写锁->读锁->死锁
乐观锁/悲观锁
乐观锁适用于读类型 版本号+CAS实现增加吞吐量
atomic下面的类使用了乐观锁
分段锁
1.7jdk的concurrentHashMap
默认16个并发
无锁/偏向锁/轻量级锁/重量级锁
通过对象监视器的对象头中的字段来表明的。
是JVM为了提高锁的获取和释放效率而做的优化
偏向锁:一段同步代码被一个线程所访问,那么该线程会自动获取锁,降低锁的代价
轻量级锁:锁指向偏向锁被另外一个线程访问自动升级,其他线程自选的方式尝试获取锁,不会阻塞
重量级锁:轻量级锁中 其他线程不会一直自选自选一定次数还没获取到锁,会进入阻塞同时锁升级为重量级锁
自旋锁
当一个线程获取锁,如果被其他线程已经获取则循环等待,不断判断,直到获取锁才退出循环
实现:利用CAS
当第一个线程获取锁获取成功不会进入while循环 如果A没释放锁,后面的B来了,由于不满足CAS则会进入while循环
缺点
1.某个线程持有锁时间过长 导致其他等待获取锁的线程进入循环等待消耗cpu 使用不当造成cpu使用率极高
2.不是公平的,存在线程饥饿的问题
优点
1.自选不会线程切换,一直处于用户态 不会阻塞 减少了上下文切换
2.非自旋锁得不到锁会进入阻塞状态,进入内核态,获取锁又从内核态恢复,需要上下文切换
Synchronized
同步锁,用于修饰类、实例方法、静态方法、代码块
保证原子性、可见性、有序性和可重入性
静态方法锁的是class
一个线程对同一把锁是可重入的可重入多次,多次获取一把锁
加锁原理:
对方法和代码块上锁同步方法和同步代码块都是进入同步代码之前获取锁,然后拿到锁计数器+1执行完-1,如果获取锁失败就阻塞式等待锁释放
识别方式
对方法上锁 flags里面多一个ACC——SYNCHRONIZED标志
该标志告诉JVM这是个同步方法
进入该方法之前获取相应的锁,锁计数器加1 用完 -1 ,如果获取失败就阻塞等到该锁释放
对代码块上锁
执行monitorenter指令进入然后执行monitorexit指令释放锁 monitorexit之前需要尝试获取锁,如果对象没有被锁或者已经拥有这个对象的锁,就把锁计数器+1,monitorexit执行后把锁的计数器减一
底层实现
synchronized对java对象加锁本质上是对对象头的markword操作, markword默认存储对象的HashCode,分代年龄、锁标记位,运行期间Mark Word里存储的数据和锁的状态会随锁标志位的变化而变化
对象头
jvm中需要大量存储对象,存储时需要额外的功能,需要在对象中添加一些标记字段增强对象功能,这些标记功能组成对象头
Markword存储的是对象的hashcode 分代年龄 锁标志位信息
Klass point对象指向他的类元数据指针,来表明这个对象是哪个类的实例
Monitor
EntryList
线程二发现有主人了会进入等待队列
Owner会指向持有Monitor的对象的线程
WaitSet
不加Synchronized的对象不会关联Monitor
java对象
Java对象在内存中分为三部分
1.对象头
Mark word和class metadata Address
Mark word
存储对象的hashcode、锁信息、分代年龄、GC标志等
32位JVM下的默认结构
25bit hashcode
4bit分代年龄
1bit是否是偏向锁
2bit锁标志位信息
Class Metadata Address
类型指针指向对象的元数据,JVM通过这个指针确定对象是哪个类的实例
2.实例数据
放类的实际属性信息,包括父类信息等,数组长度等4字节对齐
3.对齐填充
仅仅为了字节对齐,虚拟机要求对象的起始地址必须是8字节的整数倍
重量级锁指针会指向Monitor对象(被称为管程或监视器锁)的起始地点
被某个线程持有后进入锁定状态
有两个队列
当多个线程访问同一段同步代母时,会进入EntryList集合
当线程获取对象的monitor后进入owner并设置当前的monitor中的count计数器+1.
线程调用wait方法将释放持有的monitor,owner变成null,count-1.该线程进入waitSet集合等待被唤醒
线程执行完毕是否monitor锁并复位变量的值以便其他对象获取锁
Monitor对象存在每个Java对象头中,所以每个对象都可以作为锁
JVM中的Synchronized
锁膨胀
锁状态
001 无锁
markword内锁状态标记001
101 偏向锁
不存在竞争 总由统一线程多次获取
再次申请检查标记位markword为偏向锁以及当前线程ID即可
00轻量级锁
当第二个线程来竞争锁同一个对象时,会升级为轻量级锁,第二个线程只是申请不存在竞争锁,可以一前一后交替执行同步块
10重量级锁
同一时间多个线程竞争,且锁是轻量级时,自旋获取几次都失败后升级为重量级锁
当该对象持有轻量级锁线程1来获取时,自旋几次都失败然后进入锁膨胀,向系统申请monitor锁,对象头改为10 然后线程1进入entryList阻塞,线程0解锁时们根据monitor锁地址找到monitor将owner设置为null唤醒entryList中阻塞的线程
11 GC回收
膨胀的方向 001-->101-->00-->10不可逆
锁消除
在JIT(即使编译)编译时,对运行上下文扫描,去除不可能存在竞争的锁
比如方法的局部变量不需要
锁粗化
通过扩大锁的范围避免反复加锁和释放锁
例如执行循环100次每次都加锁锁住对象.class 采取的就是直接锁住然后100次循环
自适应自旋锁和自旋锁
自旋锁,轻量级锁获取失败后为了防止线程在操作系统层面挂起,使用自旋锁优化手段
如果长时间占用会增大开销和cpu利用过高
自适应自旋锁:自旋次数不固定,由前一次在同一个锁上的自旋时间和锁的拥有者的状态来确定。
volatile
轻量级同步机制 有可见性和有序性 每次使用被volatile修饰的变量都冲主存获取
底层原理
读屏障
在加了volatile的变量后的变量都从主存里读取,并且之后的代码不会重排序到volatile前面
写屏障
赋值操作都会同步到主存,之前的代码不会排序到volatile后面
为什么没有原子性?
因为轻量级的机制,原子操作以失败整个都失败,若遇到阻塞会等很久
MESI协议
缓存一致性协议
cpu核心
一级缓存
二级缓存
三级缓存
Lock
Reentranlock
可以设置为公平锁或者非公平锁
默认是非公平的构造参数加个true变成公平锁
NonfairSync
过程
调用lock()方法开始,通过CompareAndSetState尝试获取锁,以CAS的方式将state更新为1(原值为0才能更新成功)标记被线程重入的次数,若获取成功将当前线程标记持有锁的线程,然后加锁介绍 ,若获取失败则执行acquire方法
acquire() 如果获取锁失败加入同步队列自我阻塞
tryAcquire
用cas抢占锁
如果锁计数器为0则直接cas上锁
如果锁是自己线程拿的计数器+1 并执行setState方法
addWriter
获取锁失败的线程加入同步队列
题目:为什么addwriter要从尾部遍历
新节点pre指向tail tail指向新节点,这里的后继指向前驱指针是由cas保证线程安全的。而cas操作之后t.next=node之前会有其他线程进来,所有出现了问题,从尾部向前遍历一定能遍历到所有节点
acquireQueued
线程加入同步队列后会做什么:acquirequeue
非公平锁解锁流程
1.unlock调用release方法
2.release方法调用tryrelease方法释放锁,并调用unparkSuccessor(h)唤醒同步队列阻塞的线程
public final boolean release(int arg) {<br>//释放锁(state-1),若释放后锁可被其他线程获取(state=0),返回true<br> if (tryRelease(arg)) { <br> Node h = head;<br> //当前队列不为空且头结点状态不为初始化状态(0) <br> //h!=null是为了防止队列为空,即没有任何线程处于等待队列中,那么也就不需要进行唤醒的操作 <br> //h.waitStatus != 0是为了防止队列中虽有线程,但该线程还未阻塞,由前面的分析知,线程在阻塞自己前必须设置前驱结点的状态为SIGNAL,否则它不会阻塞自己。 <br> if (h != null && h.waitStatus != 0)<br> unparkSuccessor(h); //唤醒同步队列中被阻塞的线程<br> return true;<br> }<br> return false;<br>}
3.tryrelease方法 将线程持有的锁次数减一,若减少后线程将完全释放锁(state=0)则将该方法返回true否则返回false
FairSync
比非公平多一个hasQueuedOredecessores方法
如果是当前持有锁的线程可重入
可重入
state初始为0获取锁后变为1 然后线程A多次获取该锁state+1释放时也需要一层一层释放保证状态归0
AbstractQueuedSynchronizer(AQS)抽象的队列式同步器
state(volatile修饰的int类型)
getState()
setState()
compareandSetState()
AQS定义两种共享方式
Exclusive独占只有一个线程能执行如ReentrantLock
Share(共享)多线程共享Semaphore/CountDownLatch
CLH双向队列(多线程争用资源被阻塞时进入此队列)
结点状态waitStatus
负值表示处于有效等待状态,正值表示节已被取消所以源码中用>0 <0来判断结点状态是否正常
CANCELLED(1):表示当前结点已取消调度。当timeout或被中断(响应中断的情况下),会触发变更为此状态,进入该状态后的结点将不会再变化。<br><br>SIGNAL(-1):表示后继结点在等待当前结点唤醒。后继结点入队时,会将前继结点的状态更新为SIGNAL。<br><br>CONDITION(-2):表示结点等待在Condition上,当其他线程调用了Condition的signal()方法后,CONDITION状态的结点将从等待队列转移到同步队列中,等待获取同步锁。<br><br>PROPAGATE(-3):共享模式下,前继结点不仅会唤醒其后继结点,同时也可能会唤醒后继的后继结点。<br><br>0:新结点入队时的默认状态。
独占和共享
release()是独占模式下线程释放共享资源的顶级入口,会释放指定资源(如果彻底是否state=0)会唤醒等待队列的其他线程
tryAcquireShared(int)
共享方式。尝试获取资源
CAS
原理 Unsafe
java里的unsafe.java的compareandswapint方法
保证一个共享变量原子操作
AtomicReference
ABA问题
标志位 时间戳
解决:使用版本号
原子类底层使用CAS但是如果不成功会一直循环
ReentranReadWriteLock
atomic
无锁机制(常见无锁算法有:CAS算法),特点:非阻塞;<br><br>原子量底层的实现均是采用CAS非阻塞算法实现的,是无锁(lock-free)算法中最有名的一种(无锁算法:不使用锁机制来实现线程安全的算法,采用锁机制都会存在线程为请求锁而产生阻塞的情况),CAS不会阻塞线程从而不会带来CPU上下文切换的性能开销。<br>
cas直接自旋
修改调用unsafe类做的
原子操作没比较和交换
java.util.concurrent包为了解决这个问题,提供了一个带有标记的原子引用类”AtomicStampedReference”,它可以通过控制变量值的版本来保证CAS的正确性。不过目前来说这个类比较”鸡肋”,大部分情况下ABA问题并不会影响程序并发的正确性,如果需要解决ABA问题,使用传统的互斥同步可能回避原子类更加高效。
缺点
循环会耗时
一次性只能保证一个共享变量的原子性
ABA问题
foreach<br>
next遍历
底层还是用构造器实现的
函数式接口
只有一个方法的接口
1.Function<T,R> {} T传入参数、R返回参数
2.Predicate断定式接口
3.消费型接口
4.供给型接口
ThreadLocal
是什么?
看做线程变量,对其他线程是隔离的,ThreadLocal为变量在每个线程中创建一个副本,那么每个线程可以访问自己内部的副本变量
使用场景
1.对象跨层传递时使用可以避免多次传递,打破层次间的约束
2.线程间数据隔离
3.进行事物操作,用于存储线程事物信息
4.数据库连接 session会话管理
hreadLocal有一个静态内部类ThreadLocalMap,ThreadLocalMap又包含了一个Entry数组,Entry本身是一个弱引用,他的key是指向ThreadLocal的弱引用,Entry具备了保存key+value键值对的能力。<br><br>弱引用的目的是为了防止内存泄露,如果是强引用那么ThreadLocal对象除非线程结束否则始终无法被回收,弱引用则会在下一次GC的时候被回收。<br><br>但是这样还是会存在内存泄露的问题,假如key和ThreadLocal对象被回收之后,entry中就存在key为null,但是value有值的entry对象,但是永远没办法被访问到,同样除非线程结束运行。<br><br>但是只要ThreadLocal使用恰当,在使用完之后调用remove方法删除Entry对象,实际上是不会出现这个问题的。
为什么使用弱引用?
内存泄露问题?
线程
状态
新建
就绪
运行
阻塞
等待
超时等待
终止
如何创建一个线程
1.基础Thread类重写run方法
2.创建一个子类实例,启动线程调用start方法
2.实现runnable接口并创建启动线程
重写run方法 这个实例当做Thread的target来创建thread对象
3.使用callable和Future
FutureTask包装callable对象,可以获取call方法的返回值
调用FutureTask对象的get方法阻塞的方法
区别
线程只实现Runable和callable接口还可以继承其他类
继承Thread类无法继承其他的类
run和call多个线程共享一个target对象非常适合多线程处理同一份资源的情形
访问需要调用Thread.currentThread()方法
线程池
优点
降低资源消耗,减少线程不断创建和销毁造成的损耗
提高响应速度,任务到达无需等待线程创建
提高线程可管理性,线程是稀缺资源不能无限创建,可以统一调控,分配,监控
线程上线 32位系统下一个进程2G空间 假设一个线程128K则最多会有16384个线程
七大参数
1.corePoolSize核心线程池大小
没有任务执行时不一定是这么大刚创建时不会立即启动任务提交时才会启动
2.maxmumpoolize 最大线程数量
判断是否超过核心线程大小,超了判断队列满了没满了才判断是否超过最大线程数量 超过执行拒绝策略 4种
3.keepAliveTime空闲线程存活时间
线程数量大于核心线程大小,且处于空闲时会在指定时间后这个空闲线程被销毁
4.unit 空闲线程的存活时间单位
3的计量单位
5.workQueue工作队列
新任务提交后会先进入工作队列任务调度时取出任务
四种队列
1.arrayblockqueue
基于数组的有界阻塞队列可以防止资源耗尽
新任务进来后,会放到该队列的队尾,有界的数组可以防止资源耗尽问题。当线程池中线程数量达到corePoolSize后,再有新任务进来,则会将任务放入该队列的队尾,等待被调度。如果队列已经是满的,则创建一个新线程,如果线程数量已经达到maxPoolSize,则会执行拒绝策略。
2.Linkedblockingqueue
基于链表的无界阻塞队列
由于该队列的近似无界性,当线程池中线程数量达到corePoolSize后,再有新任务进来,会一直存入该队列,而不会去创建新线程直到maxPoolSize,因此使用该工作队列时,参数maxPoolSize其实是不起作用的
3.synchronizeQueue
不缓存任务的阻塞队列
生产者放入一个任务必须等到消费者取出这个任务。也就是说新任务进来时,不会缓存,而是直接被调度执行该任务,如果没有可用线程,则创建新线程,如果线程数量达到maxPoolSize,则执行拒绝策略
4.PriorityBlockingQueue
优先级的无阻塞队列
优先级通过compartor实现
6.ThreadFactory 线程工程
创建线程工程,可以设定线程名 以及是否为Daemon线程
7,handler拒绝策略 4种
又叫饱和策略
1.Abort Policy 默认
直接丢弃任务并抛出拒绝执行的异常
2.CallerRun Policy
如果任务拒绝添加后,调用线程池所在的线程直接执行被拒绝任务的dun方法 如果线程池被shutdown则直接抛弃任务
由调用线程(提交任务的线程)处理该任务<br><br>
缺点:有可能让主线程阻塞
3.Discard Policy
直接丢弃。什么都不做
4.DiscardPldest Policy
抛弃进队最早的任务,然后尝试把新任务放入队列
线程池运行状态(生命周期)
实际应用
核心线程数如何设置
1.调用Runtime。getRntime。avaliableProcessores 获取cpu 的线程数
四核处理器返回逻辑处理器 8
2.分析是什么密集型
IO密集型
经验2*cpu核数
找到最优需要压测
cpu密集型
当前电脑的cpu核数
过程:银行举例
1.存放优先级core>queue>maxPoolSize
2.执行优先级core>maxPoolS>queue
3.拒绝策略
四种
1.默认 拒绝+抛出异常
2.没关线程池则调用者执行
3.拒绝
4丢弃第一个任务,加入新任务
池化技术
池化技术==>事先准备好资源、有人用就拿,用完还回去<br>默认大小:2max:<br>好处:<br>1.降低资源消耗<br>2.提高响应速度<br>3.方便管理
<span style="font-size: 21.3333px;-en-clipboard:true;">线程复用、可以控制最大并发数、管理线程</span>
比较
<span style="font-size: 21.3333px;-en-clipboard:true;">最大 Deque + max</span>
并行流
1ForkJoin框架原理
ForkJoin框架是从jdk1.7中引入的新特性,它同ThreadPoolExecutor一样,也实现了Executor和ExecutorService接口。它使用了一个无限队列来保存需要执行的任务,而线程的数量则是通过构造函数传入,如果没有向构造函数中传入指定的线程数量,那么当前计算机可用的CPU数量会被设置为线程数量作为默认值。
所以当使用ThreadPoolExecutor时,使用分治法会存在问题,因为ThreadPoolExecutor中的线程无法向任务队列中再添加一个任务并在等待该任务完成之后再继续执行。而使用ForkJoinPool就能够解决这个问题,它就能够让其中的线程创建新的任务,并挂起当前的任务,此时线程就能够从队列中选择子任务执行。
ForkJoinPool主要使用分治法(Divide-and-Conquer Algorithm)来解决问题--->快排
我们可以把这个任务分割为若干互不依赖的子任务,为了减少线程间的竞争,
工作窃取算法
线程完成后去从双端队列头部去做其他线程的任务
工作窃取算法的优点:<br>充分利用线程进行并行计算,并减少了线程间的竞争。
工作窃取算法的缺点:<br>在某些情况下还是存在竞争,比如双端队列里只有一个任务时。并且该算法会消耗更多的系统资源,比如创建多个线程和多个双端队列。
<span style="color: rgb(0, 0, 0); font-family: "Helvetica Neue", Helvetica, Verdana, Arial, sans-serif; font-size: 14px;">(1)任务只能使用Fork和Join操作来进行同步机制,如果使用了其他同步机制,则在同步操作时,工作线程就不能执行其他任务了。比如,在Fork/Join框架中,使任务进行了睡眠,那么,在睡眠期间内,正在执行这个任务的工作线程将不会执行其他任务了。</span><br style="margin: 0px; padding: 0px; color: rgb(0, 0, 0); font-family: "Helvetica Neue", Helvetica, Verdana, Arial, sans-serif; font-size: 14px;"><span style="color: rgb(0, 0, 0); font-family: "Helvetica Neue", Helvetica, Verdana, Arial, sans-serif; font-size: 14px;">(2)在Fork/Join框架中,所拆分的任务不应该去执行IO操作,比如:读写数据文件。</span><br style="margin: 0px; padding: 0px; color: rgb(0, 0, 0); font-family: "Helvetica Neue", Helvetica, Verdana, Arial, sans-serif; font-size: 14px;"><span style="color: rgb(0, 0, 0); font-family: "Helvetica Neue", Helvetica, Verdana, Arial, sans-serif; font-size: 14px;">(3)任务不能抛出检查异常,必须通过必要的代码来出来这些异常。</span>
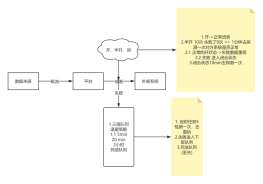
生产者消费者问题
代码的问题,线程也可以唤醒而不被通知,虚假唤醒,所以为了防止虚假唤醒等待必须放到while中
<div>把 while (product >=1) {}</div><div>换成 if (product >=1) {}</div><div>就会出现虚假唤醒</div>
因为if只会执行一次,执行完会接着向下执行if()外边的<br>而while不会,直到条件满足才会向下执行while()外边的<br>
如果出现四个线程怎么办?<br>
CountDownLatch、CyclicBarrier、Semaphore<br>
CountDownLatch:减法计数器
CyclicBarrier:7龙珠召唤神龙
线程内部访问线程外部遍历需要提升作用域 final
Semaphore:信号量
semaphore.acquire()获得锁,如果满了就等待直到释放锁<br>semaphore.release()释放,会将当前的信号量释放+1,然后唤醒等待的线程
condition
面试题:
1.run和start的区别
run只是普通的方法 start开启线程进入可运行状态 何时执行由cpu调度
2.两次start会出现什么情况
抛出异常,被认为是编译错误
3.线程间通信
共享内存
消息传递
4.线程间同步
synchronized +wait/notify
cas
volatile
信号量
reentrantlock
ThreadLocal
5,线程返回值
callable
6.reentranlock和synchronzied的区别和原理
相同点
都是可重入锁,阻塞式同步,线程阻塞和唤醒时 代价高 有用户态和内核态的切换
不同点
1.前者手动加锁 后者自动加锁和释放锁
2.实现上前者api层面 后者jvm层面加锁解锁
3.前者默认fasle 非公平锁可设置公平锁 后者只能非公平锁
4.前者可以实现多个condition对象,可以简单实现复杂的线程同步功能
5.原理不同
前者ReentrantLock套互斥锁
CAS+CLH队列来实现。它支持公平锁和非公平锁,两者的实现类似
后者:监视器
会在同步块的前后分别形成monitorenter和monitorexit这个两个字节码
7.sleep和wait的区别
1.实现方式
sleep + yield是Thread类
wait和notify是object类
2锁的状态
sleep不释放锁
wait释放锁等待被notify唤醒
8.阻塞队列BlockingQueue
add、remove
抛出异常
offer、poll
不会抛出异常
put、take
一直阻塞等待(队列没位置)
offer、poll
超时等待
9.SynchronousQueue同步队列
没有容量,进去一个元素,必须等待取出来之后,才能再往里面放一个元素
10.并发编程的内存泄漏问题ThreadLocal
多线程访问同一个共享变量容易出现并发问题
ThreadLocal是除了加锁之外的同步方式
<span style="color: rgb(77, 77, 77); font-family: -apple-system, "SF UI Text", Arial, "PingFang SC", "Hiragino Sans GB", "Microsoft YaHei", "WenQuanYi Micro Hei", sans-serif; font-size: 16px; font-variant-ligatures: common-ligatures;">ThreadLocal提供线程本地变量,每个线程拥有本地变量的副本,各个线程之间的变量互不干扰。ThreadLocal实现在多线程环境下去保证变量的安全。</span>
<div>为什么会内存泄露:</div><div>假设在业务代码中使用完ThreadLocal, ThreadLocal引用被回收了</div><div>由于threadLocalMap只持有ThreadLocal的弱引用, 没有任何强引用指向threadlocal实例, 所以threadlocal就可以顺利被gc回收, 此时Entry中的key = null</div><div>在没有手动删除Entry以及CurrentThread依然运行的前提下, 也存在始终有强引用链CurrentThread 引用 → CurrentThread →ThreadLocalMap-> entry,value 就不会被回收, 而这块value永远不会被访问到了(因为key=null), 导致value内存泄漏</div><div><br></div><div>解决办法:使用完ThreadLocal后需要调用remove方法,删除对应的 Entry ,就能避免内存泄漏</div>
Collect
Get Started
Collect
Get Started
Collect
Get Started
Collect
Get Started
评论
0 条评论
下一页