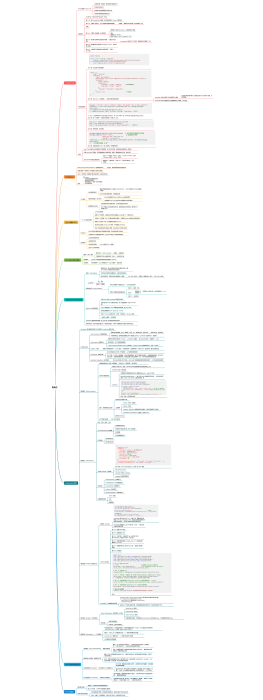
传统方法
落域模块(意图识别模块)
使用浅层的分类模型,将用户的query进行快速落域分类,把明显不是属于该领域的数据先过滤掉
语义路由
优点
拓展性
精确(减小检索范围)
检索效率高(减小数据集)
多路召回源
思路
将字面相似的传统搜索算法与向量相似性检索相结合,实现混合搜索
可以加权融合分数、取各自topk检索后并集或RRF+Rerank
方法
es里的bm25
浅层语义召回x2vec
深度语义召回DSSM
qq匹配
qa匹配
知识图谱——主要用于推荐系统、客户画像系统里
graph embedding召回
专有名词、实体词召回
query改写或扩展
核心
通过生产多个用户查询并重新排序结果。利用逆向排名融合和自定义向量评分加权进行综合、准确的搜索
思路
让LLM去优化用户的query,改写query,尝试从多个角度补充原来的问题,变成多个问题尽量全面的从向量数据库中查找结果
丰富搜索信息后,都分别喂入LLM
获取到回复后,使用RRF得到统一得分,重排去TOPk检索结果
工作流程
多查询生成
单一查询可能无法完全捕捉用户感兴趣的全部范围,或者可能过于狭窄而无法产生全面的结果
工作原理
调用语言模型
自然语言查询
多样性和覆盖范围
逆向排名融合(RRF)
为什么选择RRF
它不依赖于搜索引擎分配的绝对分数,而是依赖相对排名,使其非常适合结合可能具有不同规模或分数的查询结果
生成性输出
用户意图保留
将重新排名后的文档和所有查询输入到LLM提示中,以生成典型的RAG方式的生成性输出
优点
更优质的源材料
增强用户意图
结构化、富有洞见的输出
自动纠正用户查询
处理复杂查询
搜索中的意外发现
增加重排序rerank
推荐/搜索的做法,把检索过程做成漏斗型。多次排序
追问机制
改善用户体验——prompt 如果无法从从背景知识问答用户的问题,则根据背景知识内容,对用户进行追问,问题限制在3个以内
关键信息提取
利用NLP的句法分析、NER、依存分析、语义角色标注、关键词提取等去抽取关键信息,添加到层级检索的顶部。
更小的text chunk 配合更大的topk
why
embedding 本身效果一般
多语言问题
为了检索精准,通常会使用小的chunk,但是会牺牲上下文
优化思路
扩充句子窗口
检索到最高得分的chunk,前后添加一定数量的chunk再发送给LLM
自动合并检索
在叶子节点搜索,采用一定的算法判断是否需要合并到具有更丰富语义的父节点上
查询分解
将问题分解为子问题
序列求解,将上一个子问题的答案和当前问题一并扔给LLM,直到最后一个问题
并行独立回答问题,然后将多路答案合并为最终答案
Step Back
Google paper 提出:将问题进行总结,让问题更加抽象,从而扩大检索范围
大模型辅助召回策略
HYDE
流程
根据query生成k个答案
向量化query 和k个answer
融合全部向量,生成向量v
利用向量v召回文本
优点
更全面的捕获查询意图和上下文,提高召回文档的相关性
缺点
答案虚假
非常依赖LLM的能力,微调过后的模型效果堪忧
FLARE
方法
被动
固定token召回
一个完整句子就召回一次
用户query分解为子问题,需要解答子问题的时候,进行召回
主动
模型自己决定召回时机
缺点
LLM不愿意主动召回
LLM过于频繁主动召回
需要微调模型
gpt无法使用,无法得到每个词的概率
基于可信度
思路
对query进行召回,让LLM生成答案,没一个完整的句子都进行可信度评估,如果低于某个阈值,则进行再进行召回
基于上下文查询细化
通过上下文重述问题,解决代词的问题
分层索引检索
将文档建立多层索引,优先检索与查询最相关的摘要部分,再深入到详细文档。参照字典查询流程
改善检索对称性
对文档进行预处理,例如使用gpt为每个文档生成hypothetical/possible的问答对列表。然后使用生成的问题作为要潜入的块进行处理。检索时同时检索query和answer。
去重信息
知识图谱
方式
利用NL2Cypher对query进行KG增强
处理方式
先根据query进行实体抽取,然后把实体作为种子节点对图进行采样。然后把获取的子图转换为文本。(必要时也可以把KG节点和query中的实体先向量化进行相似度比对)
跨模态搜索
多向量检索器
将文档和引用分离,针对不同的数据类型生成适合自然语言检索的摘要,同时保留原始数据的内容。根据使用大模型的类型觉得summary的方式