高级JAVA面试
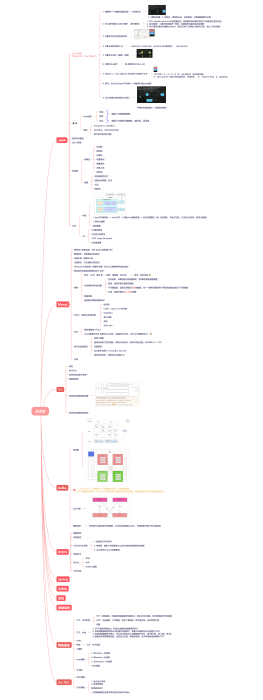
2026-09-24 09:49:42 0 举报在高级JAVA面试中,考察候选人对Java核心概念、设计模式、多线程、并发、JVM、框架(如Spring和Hibernate)的深入理解至关重要。此外,面试官通常要求候选人阐述他们对RESTful服务、微服务架构和容器技术(如Docker和Kubernetes)的实践知识。对于算法和数据结构的熟悉程度,以及在实际项目中的问题解决能力和经验也是面试的一部分。候选人应具备良好的代码编写能力,并能够清晰地阐述自己的思路和设计决策。
高级java
模板推荐
作者其他创作
大纲/内容
JAVA
大厂七连问<br>Object obj = new Object()
1. 请解释一下对象的创建过程?(半初始化)
1. 对象的创建;2. 初始化:调构造方法,设初始值;3.装载数据建立关联
2. DCL要不要加volatile问题?(指令重排)
1. DCL: double check lock 锁双重验证,例如懒汉单例模式加两个if判断是否实例为空;<br>2. 指令重排? 只要不影响最终一致性,系统就有可能发生指令重排<br>3. 所以单例对象必须要加volatile,因为它保证了线程之间的可见性、禁止了指令重排
3. 对象在内存中的存储布局?
<br>
4. 对象头具体包括什么?
markword(hashCode、synchronized锁信息) 、class pointer
5. 对象怎么定位(直接、间接)
<br>
6. 对象怎么分配?
栈-线程本地-Eden-old
7. Object o = new Object() 在内存中占用多少字节
16个字节:8 + 4 + 0 + 4(8:markWord(64位的机器)<br>4:class pointer(默认开启压缩为4,关闭为8)、0: instance data、4:padding)<br><br>
8. 思考:为什么hotspot不适用c++对象来代表java对象?
9. class对象在堆还是在方法区?
<br>严格来讲是放堆中,方便反射调用
基础
java对象?
封装<br>
继承
多态
集合
ArrayList vs. LinkedList
array:底层是数组实现,便于访问
linked:底层是双向链表实现,便于插入、删除
hashMap、linkedHashMap
hashMap
1. 数据结构:数组 + 链表/红黑树<br>2. 无序
linkedHashMap
1. 数据结构:双向列表 + hashMap<br>2. 有序:插入顺序 或 访问顺序(可配置)<br>
高并发中集合的问题
Vector, Hashtable:线程安全,使用synchronized修饰方法,<br>缺点:效率低
arrayList、hashMap,线程不安全,想要线程安全可以Collections.synchronizedList(list); Collections.synchronizedMap(m);<br>缺点:不够灵活、效率不高
java.util.concurrent.*<br>效率高、线程安全
面试热点题型
hashCode()和equals() 关系
每个对象都有一个hashCode,要判断两个对象相等,必须hashCode和equals都相同
== 和 equals的区别
== :基本数据类型,比较值;引用类型比较地址
equals():比较值,看是否重写过equals()
String、StringBuffer、StringBuilder
1. String 不可变字符串常量,创建完成后存放在方法区中<br>2. buffer,可变、线程安全<br>3. builder 可变、非线程安全
泛型中extends和super的区别
<? extends T> :表示任何T以及T的子类
<? super T> :表示任何T以及T的父类
ApplicationContext和BeanFactory有什么区别
BeanFactory是Spring中非常核心的组件,表示Bean工厂,可以生成Bean,维护Bean,而ApplicationContext继承了BeanFactory,所以ApplicationContext拥有BeanFactory所有的特点,也是一个Bean工厂,但是ApplicationContext除开继承了BeanFactory之外,还继承了诸如EnvironmentCapable、MessageSource、ApplicationEventPublisher等接口,从而ApplicationContext还有获取系统环境变量、国际化、事件发布等功能,这是BeanFactory所不具备的
B树和B+树的区别,为什么Mysql使用B+树?
Volatile和Synchronized有什么区别?Volatile能不能保证线程安全?DCL(Double Check Lock)单例为什么要加Volatile?
1、Synchronized关键字,用来加锁。Volatile只是保持变量的线程可见性。通常适用于一个线程写,多个线程读的场景。<br>2、不能。Volatile关键字只能保证线程可见性,不能保证原子性。<br>3、Volatile防止指令重排。
JAVA线程锁机制是怎样的?偏向锁、轻量级锁、重量级锁有什么区别?锁机制是如何升级的?
1. JAVA的锁就是在对象的Markword中记录一个锁状态。无锁,偏向锁,轻量级锁,重量级锁对应不同的锁状态。<br>
2. JAVA的锁机制就是根据资源竞争的激烈程度不断进行锁升级的过程。
偏向锁
只是告诉大家,这里有一个锁,实际没上锁(例如门卫写着“有序访问”提醒)
轻量级锁(自旋锁)
等待锁的释放,自己来回的请求锁资源
重量级锁
程序不需要自旋等待了,你就站着等系统通知你,缺点:cpu调度压力大
谈谈你对AQS的理解。AQS如何实现可重入锁?
1. AQS是java实现线程同步的一个框架,是jdk中很多锁核心的实现框架
2. 在AQS中,维护了一个信号量 state、维护了一个双向链表,用来存放线程队列的,而state就类似于交通信号灯,用来只会队列中的线程调度
可重入锁的实现?<br>aqs中,state表示锁的次数,lock时state+1,unlock时state-1
五、有A,B,C三个线程,如何保证三个线程同时执行?如何在并发情<br>况下保证三个线程依次执行?如何保证三个线程有序交错进行?<br>CountDownLatch, CylicBarrier(等待线程都到达屏障点,开始执行), Semaphore.
如何对一个字符串快速进行排序?
Fork/Join框架
大批量数据排序
将任务拆分成多个子任务 让这个框架帮我们管理和调度线程 提高线程利用率 从而提升了性能
jdk1.8特性
1. 接口默认方法
2. Lambda 表达式
3. 函数式接口
4. 方法和构造函数引用
允许使用::关键字来传递方法或者构造函数引用
5. Lambda 作用域
在lambda表达式中访问外层作用域和老版本的匿名对象中的方式很相似。你可以直接访问标记了final的外层局部变量,或者实例的字段以及静态变量。
6. 访问局部变量
我们可以直接在lambda表达式中访问外层的局部变量
7. 访问对象字段与静态变量
和本地变量不同的是,lambda内部对于实例的字段以及静态变量是即可读又可写。该行为和匿名对象是一致的
8. 访问接口的默认方法
多线程
锁概念
乐观锁
一般是加版本号更新,若版本号不变更新成功,若版本号变了更新失败,这就是cas机制
偏向锁
自旋锁
轻量级锁
重量级锁
可重入锁
读写锁
线程
实现线程的方式
extends Thread
implements Runnable,实际thread也是继承自Runnable
implements callable,和线程池搭配使用,有返回值
线程生命周期、状态
<br>
AQS
<br>
线程池
结构图
<br>
核心参数
<br>
keepAliveTime
空闲线程数量保持链接时间,(时机:空闲线程数 > 核心线程数,这个条件可通过allowCoreThreadTimeOut设置,是个boolean值)
corePoolSize
核心线程数大小
cpu密集型计算:<= cpu核数
io密集:一般是cpu核的2倍,具体情况得看
maximumPoolSize
最大线程数大小
RejectedExecutionHandler
拒绝策略
ThreadFactory
线程工厂
队列
队列用于存储线程的数量,核心线程 -> 最大线程 -> 执行拒绝策略
有界队列
无解队列
SynchronousQueue
1. 队列容量为0,来一个任务就创建一个线程,一直到maximumPoolSize<br>2. 线程可设置keepAliveTime
拒绝策略
<br>
DiscardPolicy
什么都不做,直接丢弃
AbortPolicy
抛异常
DiscardOldestPolicy
它丢弃最老的未处理请求,然后重试执行
CallerRunsPolicy
在execute方法的调用线程中运行被拒绝的任务,如果执行器关闭,丢弃
JVM
构成
1. java文件编译后 -> class文件 -> 加载class装载系统 -> 运行时数据区(堆、栈(线程)、本地方法栈、方法区(元空间)、程序计数器)
1. 程序计数器
1. 解释:当前正在运行或即将运行的程序代码编号
2. 程序计数器存在的原因:java是多线程的,现成抢占cpu资源是线程会被挂起等待执行,计数器的作用相当于offset
类加载器
双亲委派模型
GC
GC基础回收
<br>
可达性分析算法
从根节点查找被该对象应用的所有对象,比较出来,其他无用对象清理
STW(stop the world)
执行GC时,会停止用户线程,为什么?<br>答:如果不停掉用户线程,上一次标记好的在用的对象可能已经没有root根了,是无用对象,会干扰GC回收,所以stp可以提高GC效率
垃圾收集器
<br>
serial
串行,仅适用单线程项目,GC时stw
parallel
并行,GC时同样stw,只是增加了GC的线程数量
PS+PO
是jdk1.8默认的垃圾回收器,并行GC,在多cpu的情况下性能提升还不错
CMS
<br>1. 核心思想:将STW的分散,在执行GC的时候,允许一部分用户线程继续执行;<br>2. 整个GC分为4个阶段(标记清除)<br>A. 初始标记:STW,只标记出GCRoot直接引用的对象<br>B. 并发标记:继续标其他对象,与用户线程并发执行<br>C. 重新标记:STW,对并发标记阶段的对象重新标记<br>D. 并发清理:清理过程中,因为用户线程还继续在运行,所以会产生浮动垃圾,等待下一次GC清除
三色标记
cms的核心算法
三色标记:是一种逻辑上的抽象。将每个内存对象分成三种颜色:黑色:表示自己和成员变量都已经标记完毕。灰色:自己标记完了,但是成员变量还没有完全标记完。白色:自己未标记完。<br><font color="#ff535c">CMS通过增量标记 increment update 的方式来解决漏标的问题。</font>
G1
1. 解释:Garbage First 垃圾优先<br>2. 内存模型中,对于堆内存,不再划分新生代(逻辑上还是划分)、老年代,而是划分为一个个区域块,叫做region,每个region可以属于不同的年代;<br><br>
GC过程:<br>A. 初始标记:STW,只标记出GCRoot直接引用的对象<br>B. 标记Region,通过RSet标记出上一个阶段标记的Region引用到的Old区Region;RSet(每个区域中用来记录老年代和新生代关系的集合)<br>C. 并发标记:标记GCRoot下的子对象,只不过不会遍历全部的old区,只会处理上一步标记过的region<br>D. 重新标记:STW,对并发标记阶段的对象重新标记<br>E. 并发清理:与CMS不同的是,G1可以采用拷贝算法,直接将整个Region中存活的对象拷贝到另一个Region。而这个阶段,G1只选择垃圾较多的Region来清理,并不是完全清理。
ZGC
Mysql
B树和B+树的区别,为什么Mysql使用B+树?
区别:<br>1. B树没有在叶子节点维护双向指针,不能很好的支持范围查询<br>2. B树的每个节点都存储了索引和数据,所以B树的索引元素不重复,B+树的只有叶子节点存储数据,所以B+树有重复索引元素<br>=====<br>1. 树的高度不能太高,否则查找效率低下<br>2. 数据量大的情况,我们希望宽度尽可能的宽,索引衍生出了B+树,其实就是在B树的基础上拓展了多路数,存在磁盘中按照一定的大小划分(默认16k)<br>3. mysql中索引出了B+树,还有hash,hash索引的时间复杂度是O(1),速度非常快,但是一般我们不用,缺点:hash不支持范围查询、会有hash冲突
聚集索引、非聚集索引的区别
1. 聚集索引:索引和数据存储在一起,查找效率较高<br>2. 非聚集索引:索引和数据分开存储,需要两次查找才能定位到数据
存储引擎(都是B+树)
innodb
1. 存储文件:frm:表结构文件,ibd:索引以及数据<br>2. 由于只用了一个ibd文件,所以属于聚集索引
myisam
1. 存储文件:frm:表结构文件,myi:索引文件,myd:数据文件<br>2. 由于索引和数据分开存储,属于非聚集索引
主键索引、非主键索引的区别
主键索引直接存储了索引和索引所在行的数据,而非主键索引存储了索引和主键索引,主键索引查找较快;非主键索引属于非聚集索引
为什么innodb的表一定要有主键?为什么又推荐使用自增主键?
1. mysql会自动找一列不重复的数据作为索引,如果没找到,有rowId这个隐藏列机制作为索引,为了减轻mysql的压力,主键还是明确的好<br>2. 自增主键为数字类型,索引在查找过程中会比uuid这种方式快。<br>3. 自增主键的优势:方便B+树的排序,减少树的分裂次数,降低mysql压力
联合索引的底层存储结构长什么样?
从左到右排序,遵循最左前缀原则-设计原理:每个字段都是排好序的,先定位左边的才方便以此查询
事务
特点:ACID(原子性、一致性、隔离性、持久性)
思考:如何体现
并发事务带来的问题
丢失更新:A事务提交或者撤销时,把B事务更新数据覆盖
脏读:读到未提交更新的数据
不可重复读:读到已经提交<font color="#e74f4c">更新</font>的数据,但一个事务范围内两个相同的查询却返回了不同数据
幻读:读到已提交<font color="#ff535c">插入/删除</font>数据
隔离级别
读未提交:允许脏读
读已提交:只能读取到已经提交的数据
可重复读(默认):在SQL标准中还存在幻读,但MySQL中已解决幻读
串行读:完全串行化的读
串行化的实现原理:在读的时候加锁,会阻塞写
查询操作需要用事务吗?
1. 看事务隔离级别<br>2. 看业务场景
例子:<br>1. 统计报表数据,使用可重复读事务,保证数据是同一时刻的
MVCC(多版本并发控制)
版本链
三个隐藏列:row_id、trx_id、roll pointer
COW:copy on write机制
更新数据时,先复制一个副本,原来的数据继续使用,修改完成后直接覆盖替换<br>mvcc类似于这个机制,不过是加了版本链,保证可以回滚
ReadView
核心问题
判断版本链中哪些版本对当前事务可见
版本链访问记录判断辑
实现
Read Committed:每一次进行普通select操作前都会生成一个ReadView
Repeated Read:只在第一次执行普通select操作前生成KeadView,之后的查询操作都重复使用这个ReadView
关于undo
insert undo:事务提交即释放
update undo:需要支持MVCC,不能立即删除
delete mark:记录打删除标记(逻辑删除)
日志
更新是都做了什么?
<br>1. 先查询缓存中有没有这条记录,如果没有查询ibd文件加载到缓存,之后跟新缓存-更新redo日志,之后mysql异步刷盘到ibd文件进行持久化
mysql更新时为什么要写redo日志,再刷新ibd文件,为什么不直接写ibd?
1. 提高性能,写redo日志是顺序写,效率很高,而写ibd是随机写,效率低<br>2. redo日志写的方式是在<font color="#ff535c">同一个</font>文件末尾追加,所以是顺序写
索引失效的情况
使用了函数
查询列使用了隐式转换,例如int的字段,用字符串去匹配,WHERE id = '123';
范围查询
!= 或者 <>
like '%xxx'
or
全文索引使用了 Is null 或 is not null
使用in的时候,子查询中也用到了in
行锁
MQ
说明
优点:<br>1、异步处理<br>2、解耦<br>3、削峰
MQ产品
Kafka
优点
吞吐量高、性能好、集群高可用
缺点
可能会导致数据丢失、功能比较单一
适用场景
日志分析、大数据采集
RabbitMQ
优点
消息可靠性高、功能全面
缺点
吞吐量低
适用场景
小规模场景
RoketMQ
优点
吞吐量好、性能好、集群高可用、功能全面
缺点
开源版不如阿里商用版、客户端仅支持java
使用场景
没有特殊要求
如何保证消息不丢失?
消息可能丢失的场景
<br>
1. 生产者发送消息时丢失<br>2. 消费消息时丢失<br>3. 发生主从消息同步时丢失<br>4. 消息存盘时丢失
解决方案
1. 发送消息丢失
kafka
消息发送+成功回调
RocketMQ
1. 消息发送+成功回调<br>
2. 事务
RabbitMQ
1. 消息发送+成功回调
2. 手动事务:<br>channel.txSelect()开启事务,channel.txCommit()提交事务<br>式对channel是会产生阻塞的,造成吞吐量下降
3. PublisherConfirm。整个处理流程跟RocketMQ的事务消息,基本是一样的。
2. 主从消息同步消息丢失
kafka
通常用在允许消息少量丢失,acks[0、1、all] 参数调节
RocketMQ
1、普通集群中,同步同步、异步同步。异步同步效率更高,但是有丢消息的风险。同步同步就不会丢消息。<br>
2.Dledger集群-两阶段提交
RabbitMQ
1. 普通集群:消息是分散存储的,节点之间不会主动进行消息同步,是有可能丢失消息的。
2.镜像集群:镜像集群会在节点之间主动进行数据同步,这样数据安全性得到提高。
消息存盘时丢失
RoketMQ
同步刷盘异步刷盘:异步刷盘效率更高,但是有可能丢消息。同步刷盘消息安全性更高,但是效率会降低。
RabbitMQ
将队列配置成持久化队列。新增的Quorum类型的队列,会采用Raft协议来进行消息同步。
消费是丢失数据
kafka
手动提交offset
rocketMQ
使用默认的方式消费就行,不要采用异步方式。
rabbitMQ
autoCommit --修改->手动提交offset
消费幂等性
所有MQ产品并没有提供主动解决幂等性的机制,需要由消费者自行控制。
如何保证消息顺序消费
<br>
如何保证消息高效读写
传统的拷贝方式<br>
<br>
零拷贝
mmap
<br>
transfile
<br>
Kafka
架构图
<br>
<br>
1. 一个partition,只能被同一个消费者组中的一个消费者消费;<br>2. 多个消费者消费同一个partition其实是各自消费各自的重复消息,增加消费者组并不能解决消息积压
主从关系
<br>
集群选举:
所有的节点都会想ZK写数据,水先成功谁就是master,利用的是ZK的分布式锁实现
REDIS
数据结构
String
Hash
List
Set
zSet
底层结构
类似java中的hashMap,解决hash碰撞问题用的是rehash(扩容:redis扩容因子设置的较小,扩容后会重新根据容量计算key的hash值)策略
redis为什么很快
1. 直接运行在内存中
2. 单线程,避免了多线程在cpu运行时挣多资源的时间浪费
3. redis采用了epool多路复用
常用命令
scan
setNx?
持久化
RDB
快照数据文件(二进制)<br><font color="#ff535c">缺点</font>:可配置1分钟内,有1000次变动,才会更新快照,有丢失数据的风险,如果修改为一秒钟内一次变动就存储快照的话,性能不好
AOF
存储的是执行过的修改命令,根据修改命令来还原数据<br><font color="#ff535c">缺点:数据量很大的时候,redis启动慢,因为要恢复大量数据;有可能同一个key被操作很多次,其实只需要最后一次结果</font>
redis4.0策略
rdb和aof混合持久化<br><br>
1. 持久化文件依然存在AOF文件中
2. AOF文件的前面一部分存储rdb格式的二进制数据,后面存储执行命令
3. 会发生AOF重写(对于同一个key的多次操作,只记录最后一次),在重写的时候会生成redis的快照,后续的修改继续使用AOF
分布式锁
问题:只用setNx 或者 incr 原子操作加锁后删除key,同时设置超时时间(<font color="#ff535c">万一中途jvm挂了,那锁永远无法删除,释放不了),但是超时时间不好评估(根据业务来)</font>
<br>
解决:使用redsson
框架帮我们封装好了
其实就是给key设置了超时时间,然后有一个线程去轮寻,你的当前线程是否还持有这个锁
缺点:其他线程自旋等待,消耗cpu资源
分布式锁key创建完成之后,正好这是发生了主从切换,key没有同步到从节点,主节点又挂逼了,这时候会导致key丢了,影响业务?<br>答案: 可以使用zookeeper
zookeeper分布式锁
<br>
Spring
IOC
什么是控制反转?<br>将bean的控制权交给spring管理
什么是DI<br>依赖注入,把对应的属性值注入到对象当中
容器
存储对象,使用map结构来存储,在spring中一般存在三级缓存,singletonObjects存放完整的bean对象,<br>整个bean的生命周期,从创建到使用到销毁的过程全部都是由容器来管理(bean的生命周期)
<span style="font-size: inherit;">容器中bean的创建过程:</span><br><span style="font-size: inherit;">1、(beanFactory,DefaultListableBeanFactory),向bean工厂中设置一些参数</span><br><span style="font-size: inherit;">(BeanPostProcessor,Aware接口的子类)等等属性</span><br><span style="font-size: inherit;">2、加载解析bean对象,准备要创建的bean对象的定义对象beanDefinition,(xml或者注解的解析过程)</span><br><span style="font-size: inherit;">3、beanFactoryPostProcessor的处理,此处是扩展点,PlaceHolderConfigurSupport,ConfigurationClassPostProcessor</span><br><span style="font-size: inherit;">4、完成BeanPostProcessor的注册功能,方便后续对bean对象完成具体的扩展功能</span><br><span style="font-size: inherit;">5、通过反射的方式将BeanDefinition对象实例化成具体的bean对象,</span><br><span style="font-size: inherit;">6.bean对象的初始化过程(填充属性,调用aware子类的方法,调用BeanPostProcessor前置处理方法,调用init-mehtod方法,调用</span><br><span style="font-size: inherit;">BeanPostProcessor的后置处理方法)</span><br><span style="font-size: inherit;">7、生成完整的bean对象,通过getBean方法可以直接获取</span><br><span style="font-size: inherit;">8、销毁过程</span>
<br>
生命周期<br>1、实例化bean:反射的方式生成对象<br>2、填充bean的属性:populateBean(,循环依赖的问题(三级缓存)<br>3、调用aware接口相关的方法:invokeAwareMethod(完成BeanName,BeanFactory,BeanClassLoader对象的属性设置) <br>4、调用BeanPostProcessor中的前置处理方法:使用比较多的有(ApplicationContextPostProcessor,设置<br>ApplicationContext,Environment,Resourceloader,EmbeddValueResolver等对象)<br>5、调用initmethod方法:invokelnitmethod(),判断是否实现了initializingBean接口,如果有,调用afterPropertiesSet方法,没有就不<br>调用<br>6.调用BeanPostProcessor的后置处理方法:spring的aop就是在此处实现的,AbstractAutoProxyCreator<br>注册Destuction相关的回调接口<br>7、获取到完整的对象,可以通过getBean的方式来进行对象的获取<br>8、銷毁流程,1;判断是否实现了DispoableBean接口,2,调用destroyMethod方法
<br>
循环依赖解决
情况 A 依赖b,B依赖a
在初始化的时候,由于互相都不是完整对象,所以无法引用;解决思路就是提前暴露对象,属性先指向引用地址,后续再赋值
会发现A对象是存在的,只不过此时的A对象不是一个完整的状态,只完成了实例化但是未完成初始化, 如果在程序调用过程中,拥有了某个对象的引用,能否在后期给他完成赋值操作,可以优先把非完整状态的对象优先赋值,等待后续操作 来完成赋值,相当于提前暴露了某个不完整对象的引用,所以解决问题的核心在于实例化和初始化分开操作,这也是解决循环依赖问题的<br>关键, 当所有的对象都完成实例化和初始化操作之后,还要把完整对象放到容器中,此时在容器中存在对象的几个状态,完成实例化=但未 完成初始化,完整状态,因为都在容器中,所以要使用不同的map结构来进行存储,此时就有了一级缓存和二级缓存,如果一级缓存中有 了,那么二级缓存中就不会存在同名的对象,因为他们的查找顺序是1,2,3这样的方式来查找的。一级缓存中放的是完整对象,二级缓<br>存中放的是非完整对象<br>为什么需要三级缓存?三级缓存的value类型是ObjectFactory.是一个函数式接口,存在的意义是保证在整个容器的运行过程中同名<br>的bean对象只能有一个。<br>I<br>如果一个对象需要被代理,或者说需要生成代理对象,那么要不要优先生成一个普通对象?要 普通对象和代理对象是不能同时出现在容器中的,因此当一个对象需要被代理的时候,就要使用代理对象覆盖掉之前的普通对象,在 实际的调用过程中,是没有办法确定什么时候对象被使用,所以就要求当某个对象被调用的时候,优先判断此对象是否需要被代理,类似<br>于一种回调机制的实现,因此传入lambda表达式的时候,可以通过lambda表达式来执行对象的覆盖过程,getEarlyBeanReference()<br>因此,所有的bean对象在创建的时候都要优先放到三级缓存中,在后续的使用过程中,如果需要被代理则返回代理对象,如果不需<br>要被代理,则直接返回普通对象
AOP
事务
分布式
Dubbo
rpc基础
<br>
rpc的timeout优先级
<br>
Dubbo架构
面试题
dubbo为什不适用java的spi,而是自己重新造一个<br>
<br>
java中spi的缺点
1. java的spi没有缓存,每次都是重新加载
2. 可能同一个实现类,有不同的版本,jdk会两个实现都加载,造成资源浪费
2. dubbo升级
1. 实例按需加载,根据配置key
2. 增加了实例缓存
3. 对spring友好,提供了ioc和aop的支持
dubbo中Zk集群挂掉,发布者和订阅者还能通信么?
<br>
Zookeeper
微服务常用组件
<br>
注册中心
原理:
<br>
网关
网关分层
第一道关卡:流量网关
第二道关卡:业务网关
熔断、降级
熔断
服务熔断(终止交易),当服务A调用的某个服务B不可用时,上游服务A为了保证自己不受影响,及时切断与服务B的通讯。以防服务雪崩
降级
服务降级(执行B计划):提前预想好另外一种兜底措施,可以进行后期补救。直到服务B恢复,再恢复和B服务的正常通讯。
ZooKeeper
zNode
watcher
ACL(Access Control List)
操作节点的权限
启动流程
<br>
分布式事务
项目
数据结构
二叉树
红黑树(平衡二叉树)
B树
B+树
跳表
网络通信
TCP、UDP区别
TCP:有连接的,可靠的传输层通信传输协议:类似点对点消息,双方都准备好开始通信
UDP:无连接的、不可靠的;类似广播消息,我只管发送,收没收我不管;
问题
1. TCP为什么是3次握手,而不是2次<br>答:网络传输是不稳定的,可以防止数据丢失;例如客户端发送连接请求后,因为网络阻塞,迟迟收不到服务端回应,于是就认为这个是无效握手。而服务端在收到请求后给客户端响应了,服务端确认为这个是正常的,导致了资源浪费;此外,三次握手还能让双方协商初始序列号,确保后续数据传输的有序性和可靠性。<br>
TCP、Http
1. HTTP是应用层协议,在经过传输层时需要用到TcP<br>2. 考虑到数据链路层协议中的硬件设备能力,将最大传输单元ATU设置为1500<br>3. 应用层的数据往往很大,所以协议层会对上层数据进行拆分,输-报文段、网-分组、链-帧<br>4. 数据合并是需要规则的,比如定义长度,错误信息等,合并传输层信息需要HTTP
netty
网络
TCP、UDP区别
TCP:有连接的,可靠的传输层通信传输协议:类似点对点消息,双方都准备好开始通信
UDP:无连接的、不可靠的;类似广播消息,我只管发送,收没收我不管;
问题
1. TCP为什么是3次握手,而不是2次<br>答:网络传输是不稳定的,可以防止数据丢失;例如客户端发送连接请求后,因为网络阻塞,迟迟收不到服务端回应,于是就认为这个是无效握手。而服务端在收到请求后给客户端响应了,服务端确认为这个是正常的,导致了资源浪费;此外,三次握手还能让双方协商初始序列号,确保后续数据传输的有序性和可靠性。<br>
io模型
说明:同步/异步,是针对请求;阻塞/非阻塞:针对客户端
BIO-同步阻塞
<br>
NIO-同步非阻塞
<br>
核心组件
buffer
channel
selector
select
pool
epool
AIO-异步非阻塞
<br>
什么是IO多路复用
例子:就发服务员接待,很多人来的时候,一开始是服务员询问客户有什么需求再响应,多路复用是:等你举手说你要干什么,客户注册到这么一个事件上,服务员再去响应,谁先响应处理谁
抽象出来
react模型
1. 单reactor—单线程
<br>
2. 单reactor—多线程
<br>
3. 主从reactor—多线程
<br>
netty模型
<br>
子主题
设计模式
MVC模型
DDD模型
1. 优先设计实体<br>2. 再考虑其他
领域驱动设计
实体
值对象
聚合(按照业务聚合)
聚合根(例如下单流程的聚合根就是order对象)
防腐层
抽象出一层,保证调用别的服务不会影响当前业务实现
限界上下文
领域之间的隔离
一切围绕着能引起实体状态变化的动作来设计
贫血模型
传统pojo,只有字段和get、set
贫血失忆症
充血模型
只处理会引起当前实体状态变化的字段和方法
和DB的交互交给Repository
Collect
Get Started
Collect
Get Started
Collect
Get Started
Collect
Get Started
评论
0 条评论
下一页