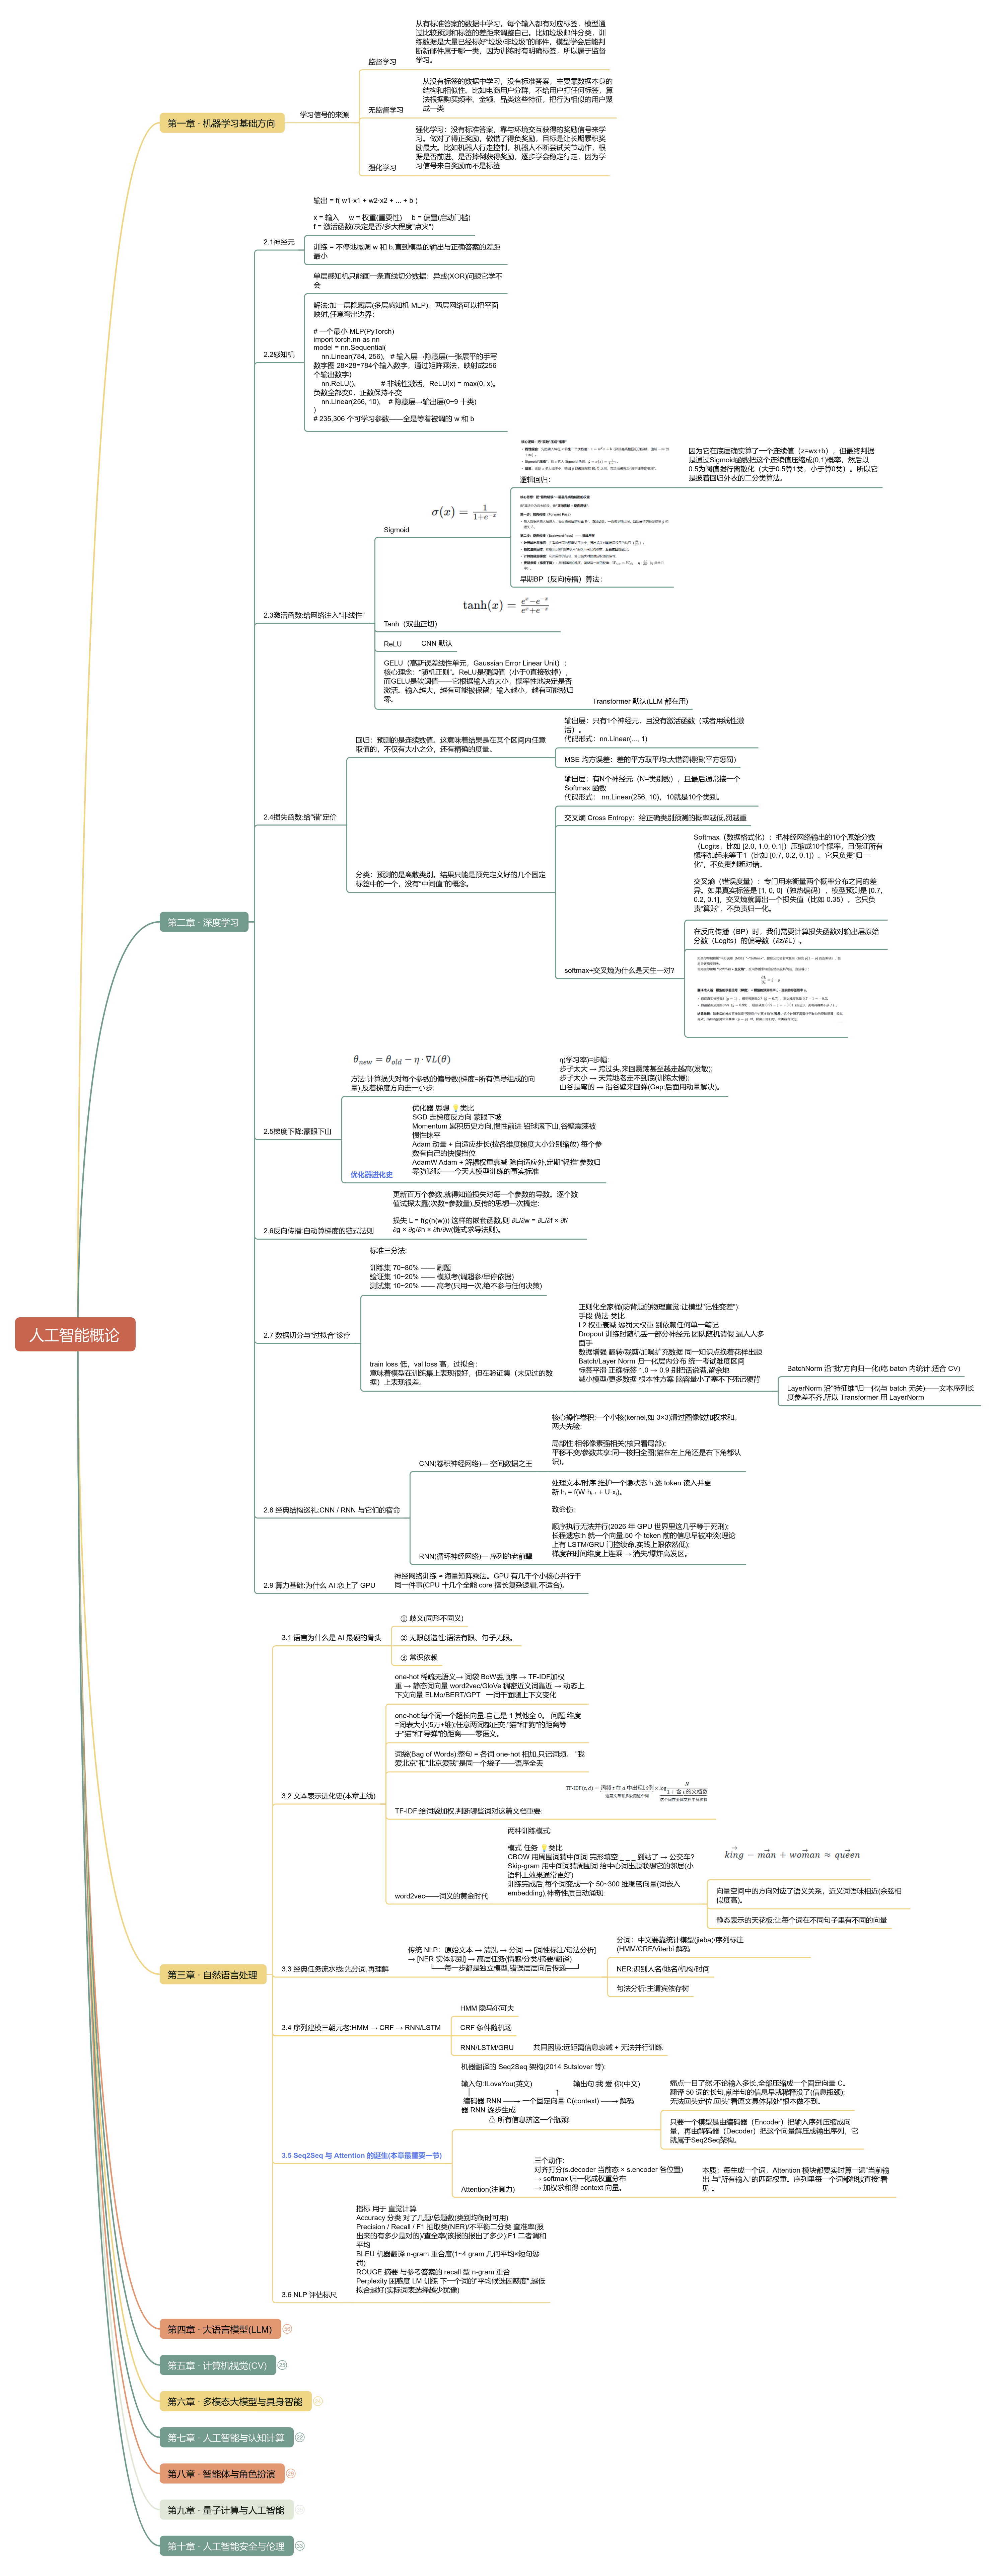
人工智能概论
2026-11-12 15:00:49 0 举报人工智能概论,大纲版
人工智能
模板推荐
作者其他创作
大纲/内容
第一章 · 机器学习基础方向
学习信号的来源
监督学习
从有标准答案的数据中学习。每个输入都有对应标签,模型通过比较预测和标签的差距来调整自己。比如垃圾邮件分类,训练数据是大量已经标好“垃圾/非垃圾”的邮件,模型学会后能判断新邮件属于哪一类,因为训练时有明确标签,所以属于监督学习。
无监督学习
从没有标签的数据中学习,没有标准答案,主要靠数据本身的结构和相似性。比如电商用户分群,不给用户打任何标签,算法根据购买频率、金额、品类这些特征,把行为相似的用户聚成一类
强化学习
强化学习:没有标准答案,靠与环境交互获得的奖励信号来学习。做对了得正奖励,做错了得负奖励,目标是让长期累积奖励最大。比如机器人行走控制,机器人不断尝试关节动作,根据是否前进、是否摔倒获得奖励,逐步学会稳定行走,因为学习信号来自奖励而不是标签
第二章 · 深度学习
2.1神经元
输出 = f( w1·x1 + w2·x2 + ... + b )<br><br>x = 输入 w = 权重(重要性) b = 偏置(启动门槛)<br>f = 激活函数(决定是否/多大程度"点火")
训练 = 不停地微调 w 和 b,直到模型的输出与正确答案的差距最小
2.2感知机
单层感知机只能画一条直线切分数据:异或(XOR)问题它学不会
解法:加一层隐藏层(多层感知机 MLP)。两层网络可以把平面映射,任意弯出边界:<br><br># 一个最小 MLP(PyTorch)<br>import torch.nn as nn<br>model = nn.Sequential(<br> nn.Linear(784, 256), # 输入层→隐藏层(一张展平的手写数字图 28×28=784个输入数字,通过矩阵乘法,映射成256个输出数字)<br> nn.ReLU(), # 非线性激活,ReLU(x) = max(0, x)。负数全部变0,正数保持不变<br> nn.Linear(256, 10), # 隐藏层→输出层(0~9 十类)<br>)<br># 235,306 个可学习参数——全是等着被调的 w 和 b
2.3激活函数:给网络注入"非线性"
Sigmoid
<br>
逻辑回归:<br>
因为它在底层确实算了一个连续值(z=wx+b),但最终判据是通过Sigmoid函数把这个连续值压缩成(0,1)概率,然后以0.5为阈值强行离散化(大于0.5算1类,小于算0类)。所以它是披着回归外衣的二分类算法。
早期BP(反向传播)算法:
Tanh(双曲正切)
<br>
ReLU
CNN 默认
GELU(高斯误差线性单元,Gaussian Error Linear Unit):核心理念:“随机正则”。ReLU是硬阈值(小于0直接砍掉),而GELU是软阈值——它根据输入的大小,概率性地决定是否激活。输入越大,越有可能被保留;输入越小,越有可能被归零。
Transformer 默认(LLM 都在用)
2.4损失函数:给"错"定价
回归:预测的是连续数值。这意味着结果是在某个区间内任意取值的,不仅有大小之分,还有精确的度量。
输出层:只有1个神经元,且没有激活函数(或者用线性激活)。<br>代码形式:nn.Linear(..., 1)
MSE 均方误差:差的平方取平均;大错罚得狠(平方惩罚)
分类:预测的是离散类别。结果只能是预先定义好的几个固定标签中的一个,没有“中间值”的概念。
输出层:有N个神经元(N=类别数),且最后通常接一个 Softmax 函数<br>代码形式: nn.Linear(256, 10),10就是10个类别。
交叉熵 Cross Entropy:给正确类别预测的概率越低,罚越重
softmax+交叉熵为什么是天生一对?
Softmax(数据格式化):把神经网络输出的10个原始分数(Logits,比如 [2.0, 1.0, 0.1])压缩成10个概率,且保证所有概率加起来等于1(比如 [0.7, 0.2, 0.1])。它只负责“归一化”,不负责判断对错。<br><br>交叉熵(错误度量):专门用来衡量两个概率分布之间的差异。如果真实标签是 [1, 0, 0](独热编码),模型预测是 [0.7, 0.2, 0.1],交叉熵就算出一个损失值(比如 0.35)。它只负责“算账”,不负责归一化。<br>
在反向传播(BP)时,我们需要计算损失函数对输出层原始分数(Logits)的偏导数(∂z/∂L)。
<br>
2.5梯度下降:蒙眼下山
方法:计算损失对每个参数的偏导数(梯度=所有偏导组成的向量),反着梯度方向走一小步:
η(学习率)=步幅:<br>步子太大 → 跨过头,来回震荡甚至越走越高(发散);<br>步子太小 → 天荒地老走不到底(训练太慢);<br>山谷是弯的 → 沿谷壁来回弹(Gap:后面用动量解决)。
优化器进化史
优化器 思想 💡类比<br>SGD 走梯度反方向 蒙眼下坡<br>Momentum 累积历史方向,惯性前进 铅球滚下山,谷壁震荡被惯性抹平<br>Adam 动量 + 自适应步长(按各维度梯度大小分别缩放) 每个参数有自己的快慢挡位<br>AdamW Adam + 解耦权重衰减 除自适应外,定期"轻推"参数归零防膨胀——今天大模型训练的事实标准
2.6反向传播:自动算梯度的链式法则
更新百万个参数,就得知道损失对每一个参数的导数。逐个数值试探太蠢(次数=参数量),反传的思想一次搞定:<br><br>损失 L = f(g(h(w))) 这样的嵌套函数,则 ∂L/∂w = ∂L/∂f × ∂f/∂g × ∂g/∂h × ∂h/∂w(链式求导法则)。
2.7 数据切分与"过拟合"诊疗
标准三分法:
训练集 70~80% —— 刷题
验证集 10~20% —— 模拟考(调超参/早停依据)
测试集 10~20% —— 高考(只用一次,绝不参与任何决策)
train loss 低,val loss 高,过拟合:<br>意味着模型在训练集上表现很好,但在验证集(未见过的数据)上表现很差。
正则化全家桶(防背题的物理直觉:让模型"记性变差"):<br>手段 做法 类比<br>L2 权重衰减 惩罚大权重 别依赖任何单一笔记<br>Dropout 训练时随机丢一部分神经元 团队随机请假,逼人人多面手<br>数据增强 翻转/裁剪/加噪扩充数据 同一知识点换着花样出题<br>Batch/Layer Norm 归一化层内分布 统一考试难度区间<br>标签平滑 正确标签 1.0 → 0.9 别把话说满,留余地<br>减小模型/更多数据 根本性方案 脑容量小了塞不下死记硬背
BatchNorm 沿"批"方向归一化(吃 batch 内统计,适合 CV)
LayerNorm 沿"特征维"归一化(与 batch 无关)——文本序列长度参差不齐,所以 Transformer 用 LayerNorm
2.8 经典结构巡礼:CNN / RNN 与它们的宿命
CNN(卷积神经网络)— 空间数据之王
核心操作卷积:一个小核(kernel,如 3×3)滑过图像做加权求和。两大先验:
局部性:相邻像素强相关(核只看局部);
平移不变/参数共享:同一核扫全图(猫在左上角还是右下角都认识)。
RNN(循环神经网络)— 序列的老前辈
处理文本/时序:维护一个隐状态 h,逐 token 读入并更新:hₜ = f(W·hₜ₋₁ + U·xₜ)。
致命伤:
顺序执行无法并行(2026 年 GPU 世界里这几乎等于死刑);
长程遗忘:h 就一个向量,50 个 token 前的信息早被冲淡(理论上有 LSTM/GRU 门控续命,实践上限依然低);
梯度在时间维度上连乘 → 消失/爆炸高发区。
2.9 算力基础:为什么 AI 恋上了 GPU
神经网络训练 ≈ 海量矩阵乘法。GPU 有几千个小核心并行干同一件事(CPU 十几个全能 core 擅长复杂逻辑,不适合)。
第三章 · 自然语言处理
3.1 语言为什么是 AI 最硬的骨头
① 歧义(同形不同义)
② 无限创造性:语法有限、句子无限。
③ 常识依赖
3.2 文本表示进化史(本章主线)
one-hot 稀疏无语义→ 词袋 BoW丢顺序 → TF-IDF加权重 → 静态词向量 word2vec/GloVe 稠密近义词靠近 → 动态上下文向量 ELMo/BERT/GPT 一词千面随上下文变化
one-hot:每个词一个超长向量,自己是 1 其他全 0。 问题:维度=词表大小(5万+维);任意两词都正交,"猫"和"狗"的距离等于"猫"和"导弹"的距离——零语义。
词袋(Bag of Words):整句 = 各词 one-hot 相加,只记词频。 "我爱北京"和"北京爱我"是同一个袋子——语序全丢
TF-IDF:给词袋加权,判断哪些词对这篇文档重要:
<br>
word2vec——词义的黄金时代
两种训练模式:<br><br>模式 任务 💡类比<br>CBOW 用周围词猜中间词 完形填空:_ _ _ 到站了 → 公交车?<br>Skip-gram 用中间词猜周围词 给中心词出题联想它的邻居(小语料上效果通常更好)<br>训练完成后,每个词变成一个 50~300 维稠密向量(词嵌入 embedding),神奇性质自动涌现:
<br>
向量空间中的方向对应了语义关系,近义词语味相近(余弦相似度高)。
静态表示的天花板:让每个词在不同句子里有不同的向量
3.3 经典任务流水线:先分词,再理解
传统 NLP:原始文本 → 清洗 → 分词 → [词性标注/句法分析] → [NER 实体识别] → 高层任务(情感/分类/摘要/翻译)<br> └──每一步都是独立模型,错误层层向后传递──┘
分词:中文要靠统计模型(jieba)/序列标注(HMM/CRF/Viterbi 解码
NER:识别人名/地名/机构/时间
句法分析:主谓宾依存树
3.4 序列建模三朝元老:HMM → CRF → RNN/LSTM
HMM 隐马尔可夫
CRF 条件随机场
RNN/LSTM/GRU
共同困境:远距离信息衰减 + 无法并行训练
3.5 Seq2Seq 与 Attention 的诞生(本章最重要一节)
机器翻译的 Seq2Seq 架构(2014 Sutslover 等):
输入句:ILoveYou(英文) 输出句:我 爱 你(中文)
│ ↑
编码器 RNN ──→ 一个固定向量 C(context) ──→ 解码器 RNN 逐步生成
⚠️ 所有信息挤这一个瓶颈!
痛点一目了然:不论输入多长,全部压缩成一个固定向量 C。<br>翻译 50 词的长句,前半句的信息早就稀释没了(信息瓶颈);<br>无法回头定位,回头"看原文具体某处"根本做不到。
只要一个模型是由编码器(Encoder)把输入序列压缩成向量,再由解码器(Decoder)把这个向量解压成输出序列,它就属于Seq2Seq架构。
Attention(注意力)
三个动作:<br>对齐打分(s.decoder 当前态 × s.encoder 各位置)<br>→ softmax 归一化成权重分布 <br>→ 加权求和得 context 向量。
本质:每生成一个词,Attention 模块都要实时算一遍“当前输出”与“所有输入”的匹配权重。序列里每一个词都能被直接“看见”。
3.6 NLP 评估标尺
指标 用于 直觉计算<br>Accuracy 分类 对了几题/总题数(类别均衡时可用)<br>Precision / Recall / F1 抽取类(NER)/不平衡二分类 查准率(报出来的有多少是对的)/查全率(该报的报出了多少);F1 二者调和平均<br>BLEU 机器翻译 n-gram 重合度(1~4 gram 几何平均×短句惩罚)<br>ROUGE 摘要 与参考答案的 recall 型 n-gram 重合<br>Perplexity 困惑度 LM 训练 下一个词的"平均候选困惑度",越低拟合越好(实际词表选择越少犹豫)
第四章 · 大语言模型(LLM)
4.1 神迹还是套路?LLM 的本质一句话
大语言模型 = 在超大规模语料上训练的"下一个词预测器"(next-token predictor)
4.2 Tokenizer:先解决"文字怎么进计算机"
BPE (Byte Pair Encoding)的完整直觉<br>神经网络吃定长数字向量,所以先把字符串切成 token,每个 token 查表变向量。
优点 解释
解决 OOV(未登录词) 遇到生僻词(如 "Transformer"),不会被扔到 <UNK>,而是切成常见的子词 ["Trans", "former"]。
平衡词表大小 不像纯字符(词表小但序列太长)或纯单词(词表巨大),BPE 能找到最优的折中点。
跨语言通用性 对于粘着语(如德语、日语),BPE 能自动切出语义块,比固定空格分词好得多。
原则:高频组合合并成一个 token,低频保持碎片。
从 token 到向量与对话模板<br>文本 → tokenize → token id 序列[15496, 11...] <br> → Embedding 查表(15万行 × 4096维的大矩阵)<br> → 加上位置信息 → 进入 Transformer 主干 ×N 层<br> → 最后 LayerNorm → LM Head(只取最后一个位置的向量)<br> → 映射回 15 万维 logits → softmax → 概率分布 → 采样
Token Embedding:映射关系就是一个巨大的矩阵(权重参数),通常叫 embedding_matrix<br>形状:[vocab_size, embedding_dim]<br>vocab_size:词表大小(比如 50,000 个 token)。<br>embedding_dim:向量维度(比如 GPT-3 用的是 12,288 维,LLaMA 7B 用的是 4,096 维)。<br>物理含义:这个矩阵有50,000×4,096≈2 亿个可训练参数。每一个 token 就对应矩阵中的一行,那一行就是它的向量表示。
模型要处理的一堆话,也就是一个 Batch,批次;
把它们打包成一个高维数组,这个数组就叫 张量(Tensor);
有了张量(Batch Size = N):你把 N 个句子堆叠成 [N, L] 的矩阵。GPU 利用并行能力,一次性把这个表格丢进 Embedding 矩阵里,瞬间同时取出 N 个句子的所有向量。
4.3 Transformer 主干逐层拆解(全书核心技术段落)
当你问“大模型怎么理解一句话”时,底层就是这一层积木在反复运作:<br><br>自注意力(带Mask):每个词环顾左边的所有词,用 Q 找 K,算出一个权重分布,然后按权重把 V 取回来。这是在找“上下文关联”。<br>
第一步:输入表示(词向量 + 位置编码)<br>输入文本—>查表得到词嵌入(Word Embedding),得到每个字的向量,堆成矩阵<br>
第二步:生成 Q、K、V(三个线性变换)<br>三个权重矩阵Wk,Wk,Wv,计算Q = X · W_Q,K = X · W_K,V = X · W_V<br>
第三步:计算 Attention(核心公式)如上—>因果遮罩(Causal Mask),把"未来位置"的分数替换成 −∞—>对每一行做Softmax(变成注意力权重,每行和为1),得到注意力权重矩阵A—>按注意力权重混合 V,计算Z=A⋅V
第四步:残差连接 + 归一化(Pre-Norm)<br>原始输入X 加上Z,然后过 RMSNorm
步骤 做了什么 直观理解<br>1. 生成 Q/K/V 用三个不同的矩阵把输入 X 投影到三个空间 同一句话,从三个角度去看(查什么、有什么标签、内容是什么)<br>2. Q·K^T 打分 每个词和所有词算相似度 "我"查一查:"爱"和"AI"跟我的关联度有多高?<br>3. 除以 √d_k 防止分数太大,Softmax 饱和 把分数拉到温和区间,让注意力"软"一些。加上因果遮罩,即第一行第一个后面变负无穷,第二行第二个后面变负无穷......<br>4. Causal Mask 把未来位置的分数设为 -inf Decoder 不许偷看未来,只能向左看<br>5. Softmax 每行变成概率分布(和为1) "我"把100%注意力放在自己身上;"爱"各放50%在"我"和自己身上<br>6. 加权求和 V 按注意力权重混合 V 每个词的最后输出 = 从所有词那里按比例取来的"内容"的加权和<br>7. 残差连接 输入 + 输出 保留原始信息,防止层太深时丢失底层特征
多头:让这种“找关联”的行为发生很多次,有的找语法,有的找语义。<br>
FFN:把注意力找回来的信息,喂进一个知识仓库,进行非线性的“理解”和“记忆”提取。<br>
FFN(x) = act(x·W₁)·W₂ (中间维度一般是隐层的 4 倍左右)
研究共识:注意力负责"信息搬运与路由",FFN 以键值对形式存储大量世界知识("巴黎→法国首都")。
MoE(Mixture of Experts)就是把单个巨大 FFN 切成多位专家,路由器按 token 选择性激活少数几个——用稀疏激活换容量:总参数几万亿,每次推理只用百分之几,Qwen/DeepSeek 旗舰都是 MoE。
位置编码:全程给这些词暗中标好了“距离感”和“顺序感”。<br>
注意力本身是集合运算(打乱顺序结果不变!)
方案 做法 状态<br>正弦编码 不同频率的正余弦叠加 元老<br>可学习绝对位置 每个位置一张可训向量 GPT-2 时代<br>RoPE 旋转位置编码 用旋转矩阵把 Q/K 旋转"角度∝相对距离",使 attention score 只依赖相对位置 当今主流<br>外推技巧 YaRN 等 微调少量参数把短窗模型拉长到长窗 长上下文标配
ROPE
把你的“工坊”复制 96 份(GPT-3)堆叠起来,前面一层处理完,后面一层继续精炼,最终在最后一层输出一个向量。这个向量再过一个分类头(Softmax),预测下一个词该是什么。
4.4 三大范式:BERT / GPT / T5 与 Decoder-only 的完胜
Encoder-only(BERT)
完形填空(挖空猜词,可双向看)
Decoder-only(GPT)
下一个词预测(带因果 mask)
Decoder-only 为什么赢?(面试高频,四条)<br><br>目标统一:预训练目标(next-token)与使用方式(生成)完全一致,SFT/RLHF 都顺滑衔接;<br>Scaling 干净:无需区分 enc/dec 结构,堆层数最简单,缩放定律直接适用;<br>KV Cache 天然友好:单向注意力意味着历史部分的 KV 可以缓存复用(见 4.7);<br>涌现能力发源地:GPT-3 已证明 in-context learning,生态全押这边,飞轮转起来了。
Encoder-Decoder(T5/BART)
4.5 预训练 Pre-training:文明的一面镜子(Transformer架构,就是预训练阶段的“骨架”),预训练出来的裸模型只会续写
数据构成(约万亿~百万亿 token):网页文本(最大头) + 代码(极重要!显著提升逻辑推理) + 书籍(长程连贯性) + 论文/百科(知识密度)。经抽取、去重、质量过滤、安全清洗四道工序;基准测试污染检测是当代必修课。
训练目标:全部 token 上做交叉熵(第二章的点在这里闭环:LLM 预训练 = 一道做了几万亿次、15 万选一的选择题)。
缩放定律 Scaling Laws(OpenAI/Chinchilla 两版):损失随参数、数据、算力呈幂律平滑下降,并可提前用小模型外推大模型性能——这是各家敢一笔投下亿美元训练的数学信心来源。Chinchilla 定律给出指导:给定算力预算,参数与数据应大致同比扩张(约为每参数 20 token)。
涌现 Emergence:某些能力(多步算术、指令遵循、翻译)在小模型几乎为零,过了某个规模线突然出现。⚠️ 学界争议:可能是度量指标造成的"跳变假象",也可能是真实相变——不管哪种,实践上"更大确实更强"至今未破产。
1. 预训练到底在“学”什么?<br>学习“语言的规律”:即语法、句法、词与词之间的共现关系。<br>学习“世界的基础知识”:它通过记忆海量文本,记住了海量事实。<br>学习“上下文的理解”:学会根据前文预测后文。
2. 预训练是怎么进行的?(核心机制)<br>核心任务:最典型的是“完形填空”或“下一词预测”。<br>做法:把互联网上抓取的海量文本(比如维基百科、新闻、小说),随机挖掉一些词(如15%),让模型去预测这些被挖掉的词是什么。<br>结果:模型通过不断对比自己的预测和正确答案,调整内部数十亿甚至万亿个参数。这个过程极其消耗算力(需要成千上万张GPU卡连续跑几个月)。
3. 预训练完成后,模型处于什么状态?<br>预训练结束后,模型是一个“基础模型”(Base Model)。<br>它知识渊博,能流畅对话,有很强的推理能力。<br>但它不一定“听话”。它可能生成有害、歧视性或错误的内容,因为它只是在模仿互联网上的所有文本,没有善恶对错之分。<br><br>这时的模型有潜力但不可直接商用。
<br>
4.6 后训练三部曲:从"续写机"到"助手"(重中之重)
第一步 SFT(Supervised Fine-Tuning 监督微调)<br>人工/AI 编写高质量"指令→回答"对(十万级量级即可,因为只是教会格式与行为,非灌输知识),交叉熵训练,对话模板、多轮格式在这一步定型。两阶段是标准形态:通用指令泛化 + 场景垂直专精
第二步 RLHF(Reinforcement Learning from Human Feedback)<br>SFT 只是模仿示范答案,不知道人类更偏好哪种风格。RLHF 三步走:<br>采集人类偏好对比("回答 A 比回答 B 好",几万对);<br>训练奖励模型 RM 给任意回答打分;<br>PPO 强化学习让策略模型最大化 RM 打分(加 KL 惩罚拴住不让飘太远)。
简化替代 DPO:跳过 RM 和在线 RL,直接用偏好对做离线优化——简单稳定,成为开源社区主流;
GRPO 则去掉价值网络按组内对比算优势,因 DeepSeek-R1 出圈成为 Agent/推理时代的热门配方
此处只需要记住:PPO=在线+RM,DPO=离线偏好对,GRPO=组内相对比较省 critic
第三步 RLVR:推理模型的诞生(2024→ 至今最前沿)
传统 RLHF 依赖主观偏好;RLVR(RL with Verifiable Reward)用程序化验证器代替 RM:数学题核对最终答案、代码跑单元测试——奖励客观不可作弊。
代表成果 o1/o3、DeepSeek-R1:不用人工示范,纯靠大规模强化学习自发涌现出长思维链(自查、回溯、"等等我再想想")。
4.7 部署与推理:从权重到服务(工程师视角)
KV Cache:推理加速的头号功臣
4.8 幻觉 Hallucination:机制的清醒认识
4.9 提示工程速成(先把模型用对,再谈微调)
4.10 评估与代表谱系(点到为止)
第五章 · 计算机视觉(CV)
5.1 图像的本质:一张巨大的数字表格
CV 的若干直觉:图像任务对旋转/平移敏感(矩阵整体变了)、数据增强有效(翻转裁剪后仍是同物体)、对抗样本存在(人眼无异的微小扰动能让分类器崩溃
5.2 卷积:CV 世界的乘法口诀
操作定义:拿一个小核(kernel,如 3×3),盖住图像一角,对应位置相乘再求和,输出一个数;滑遍全图,得到特征图(feature map)。
滑动的三个超参:<br>超参 含义 影响<br>Stride 步幅 核每次挪几格 大步长 → 特征图更小更快<br>Padding 填充 图边缘补零圈 保持尺寸不缩;边缘信息不被忽略<br>Kernel size 核大小 VGG 之后业界统一用 3×3 叠深(两层 3×3 感受野等于一层 5×5,还多了次非线性)
两个先验是 CNN 成功的全部秘密:<br>局部性:核只看小窗口——因为图像语义本来就局部性强(眼睛就是一小片);<br>参数共享:同一核扫全图——猫出现在哪都是猫(平移不变性)。
堆叠出层次:Conv+激活+Pooling(降采样取最大值)反复叠,特征图逐层变小、通道逐层变多、语义逐层抽象:
第1~3层 : 边缘 / 角点 / 简单纹理(横线竖线斜线)
第4~7层 : 纹理组合 / 局部部件(圆弧、车轮的一部分)
第8+层 : 物体级概念(脸、轮子整体)
5.3 CNN 极简史:一部"越深越好,但深不动"的攻关史
ResNet 2015 ⭐ 残差连接救了深度学习:此后所有大模型的骨架
ResNet 为什么值得单独讲? 更深的网络本应更强,但实测层数加到 50+ 后训练误差反而回升(退化问题,且不是过拟合—— train 也变差)。
何恺明的洞察:与其让深层网络学完整变换 H(x),不如让它只学"修正量":y=F(x)+x(跳跃连接/捷径)<br>
网络只需学 F(x)≈0 的恒等映射即可保证不比浅层差。梯度沿 x 直通捷径回传,梯度消失被物理性地绕开——千层网络成为可能。
5.4 任务阶梯:分类 → 检测 → 分割
任务 输出<br>分类 Classification "这是猫"(单一标签)<br>检测 Detection 猫在哪(框)+ 是什么<br>分割 Segmentation 每个像素的类别(语义分割)/每个实例分开(实例分割)/合体(全景分割)
检测的发展主线一句话:两阶段(先提候选框再精修)→ 一阶段端到端回归 → anchor-free 化 → Transformer 化(DETR 把检测变成集合匹配问题)。
5.5 Vision Transformer:当图像遇见注意力
ViT(2020 Google)核心想法简单粗暴:
图片切成固定小块 patch(如 16×16 像素);
每个 patch 展平+线性投影 = 一个 token;
加位置编码(哪个 patch 在哪)、拼上分类专用 [CLS] token;
整包丢给标准 Transformer encoder(和 LLM 同款);
取 [CLS] 输出做分类。
CNN vs ViT(面试高频对比):<br><br>维度 CNN ViT<br>先验 强(局部性+平移不变写死在结构里) 弱(全局注意力,一切靠学)<br>小数据集 稳赢(先验兜底) 容易翻车(需要更多数据)<br>超大数据/规模上限 早饱和 持续涨(ViT-L/H 吊打 CNN)<br>距离建模 浅层看不见远处,需层层堆 一步到位全局关注<br>又一次验证第一章母题:先验弱的架构在小数据吃亏、在大数据时代通吃(与 decoder-only 的胜
5.6 Diffusion:扩散模型是怎么凭空画图的
两阶段设定
前向(训练时): 把真图逐步加噪 T 步 → 直到纯噪声雪花 (规律已知)
反向(要学会): 从雪花出发,一步步减噪 → 还原成清晰图像 (这是要学的技巧)
Stable Diffusion 三大件(工业标准架构)
文生图全流程:
Prompt "戴珍珠耳环的少女风格宇航员"
→ ①CLIP Text Encoder 编码成语义向量组(条件)
→ ②潜空间中随机初始化 latent 噪声
→ ③UNet(DiT)迭代去噪 N 步,每步注入①的条件:
Classifier-Free Guidance (CFG):有条件/无条件两次预测,拉大差异
以增强文本控制力("对齐你的文字意图")
→ ④VAE Decoder 从潜空间解码回像素图 ✓
5.7 OCR 与典型应用场景
OCR 文字识别两段式(检测文本行+识别字符)
场景 用到的技术栈 备注<br>工业质检 分类+检测+异常检测 小缺陷样本稀缺→迁移学习+合成缺陷<br>自动驾驶 检测/分割/BEV 感知/占据栅格 安全冗余要求极致,多传感器融合<br>医疗影像 分割+分类(Dr.CNN 读片) 数据隐私+假阴性代价极高,辅助定位非确诊<br>遥感/农业 分割+变化检测 尺度大、目标小、云层干扰<br>AR/三维 SLAM/NeRF/3DGS 从 2D 走向空间智能
第六章 · 多模态大模型与具身智能
6.1 为什么必须多模态
信息带宽:人类输入的 80%+ 走视觉;纯文本丢掉了图表、表情、空间关系一整个世界;
任务刚需:看化验单答诊断题、读 UI 截图写前端、"这张图哪里有 P 图痕迹"——文本-only 根本无法开始;
数据天花板:高质量公开文本见底(第一章三要素预警),图像视频音频是下一个十倍量级的训练矿;
通往 AGI 的必经之路:真正的通用智能必须能感知世界、在物理世界中行动(后半句就是本章下半场的具身智能)。
6.2 VLM 标准三段式架构(面试手画图)<br>(Vision-Language Model)
① 视觉编码器
图像 → 一堆特征向量(patch token)
② 接口模块(关键!)
把视觉向量"翻译"成 LLM 认识的 token 序列
接口模块的三代演进:<br>线性投影 一个小 MLP 直接把 patch 向量投到 LLM 维度;<br>Q-Former 查询桥 少量可学习查询向量通过交叉注意力向视觉特征"抓取"信息,输出固定数量 token;<br>Cross-Attention 注入 不拼接进序列,LLM 内部设交叉注意力层直接从视觉特征取信息;<br>原生多模态 预训练阶段从头就是全模态统一 token 流,无后补接口
③ LLM 底座
拼接视觉 token + 文本 token,统一自回归生成
6.3 一次完整的多模态调用(流程走读)
以"上传一张晚餐照片问:这顿多少卡路里?"为例:
1. 图片 → 预处理(resize 到适配分辨率,动态分辨率如 Qwen-VL 按需切块保细节)
2. → ViT 编码 → N 个视觉 token(比如几百个)
3. 文本提示 "这张晚餐的照片里大约有多少卡路里?" tokenize 成 M 个 token
4. 序列拼接:[视觉token ×N][文本token ×M] 送入 LLM —— 在模型眼里全部都是 token!
5. 自回归生成:"这是一份汉堡套餐…估算约 850 千卡"(底层是逐 token 预测)
6.4 输出侧三大件:画图、做视频、配音色
方向 代表技术 一句话现状
文生图 Stable Diffusion/DiT(第五章已拆)/ControlNet 条件控制/LoRA 画风 工业级成熟,商用版权合规是主要门槛
文生视频 Sora(DiT+时空 patches)/Kling/Runway/国内可灵海螺 15~60 秒高一致性可用;物理规律偶尔"露馅"(玻璃不碎反融);算力成本极高
统一理解+生成 Chameleon/JSD/Janus 系 上升期:一个模型既懂又画,还偶有"文字渲染之谜"待解
语音 ASR Whisper(encoder-decoder 直接端到端) 多语种鲁棒,开源界地基
语音 TTS VALL-E/XTTS(3 秒克隆音色)/GPT-SoVITS 开源生态 已到真假难辨;情感韵律还在进步
数字人 语音驱动口型(LivePortrait/SadTalker)+形象驱动+实时流 直播数字人已商用;实时性与拟真度仍是价格敏感区
观察:所有模态最终都被 Transformer 化了(ViT 处理像素、Whisper 处理频谱、DiT 处理时空块)。Transformers 之于 AI,就像 CRUD 之于 Web 后端——先学它,再谈创新。
6.5 下半场:具身智能 Embodied AI
三条技术路线(当前格局)
路线 A:VLA(Vision-Language-Action)模型 把"感知-决策"两步压进一个大模型:视觉+语言指令进去,直接输出动作 token(机械臂关节角度序列)。
图像 + 指令"把桌上的杯子放进水槽"
→ VLA 大模型(RT-2/Pi0/OpenVLA/RDT 系列)
→ 动作 tokens → 机械臂控制器执行 → 新观察 → 循环
路线 B:世界模型(World Model) 让模型内化一个可模拟的物理环境引擎:给它状态和动作,它能预测下一帧会发生什么(Sora 已展示隐式世界模型的雏形;Dreamer 类在想象中练习 RL)。口号:在梦里学会骑车,再骑真车
路线 C:模仿学习 + 强化学习<br><br>模仿学习 Imitation Learning:人类遥操作示范(teleoperation,经典 ALOHA 双臂系统)录成轨迹数据集,策略网络学着复现(diffusion policy 是当前爆款:把动作生成当扩散去噪);强化学习:仿真环境中海量试错(Isaac Gym 并行数万机器人),再迁移真机;<br>未来理想态:遥操作造种子数据 → 仿真扩展规模 → 真机微调落地 的数据飞轮。
Sim2Real:仿真学的技能能带到现实吗
主流缓解:域随机化 Domain Randomization——训练时刻意随机打乱颜色/材质/摩擦力,"既然见过的世界千奇百怪,现实这点波动也算不了什么"。(这个思路本身就很有哲学味:主动注入噪声换取鲁棒性。)
数据困境:具身智能最大的瓶颈
机器人轨迹 ??? 要么真人穿设备采集($$$),要么仿真合成(gap) 稀缺一个数量级以上
第七章 · 人工智能与认知计算
7.1 认知计算 Cognitive Computing 是什么
定义:模拟人类认知过程——理解、推理、学习、交互——的计算系统,强调在人机协作中处理复杂、模糊、开放的问题。
谱系上它是 AI 的一个流派分支:比传统 AI 更强调 "增强人类决策"而非替代人类(IBM Watson 的商业化定位);比通用 AI 更聚焦于知识密集型行业(医疗诊断辅助、金融风控、法律检索)。
学认知计算的视角价值在于:它强迫你从'人类怎么思考'反推'机器该怎么设计'。
7.2 人类认知架构五分钟速修课
系统 核心特点 容量/时限
感觉记忆 各感官的原始缓冲区 极短(<1 秒),多数直接丢弃
工作记忆 Working Memory 有意识的"操作台",用于推理心算 约 4±1 个组块(Miller 7±2 经典说法;Cowan 修正为 4)
长期记忆-情景 自传体事件("去年生日") 海量,靠线索提取
长期记忆-语义 概念与事实("巴黎是首都") 海量
长期记忆-程序 运动技能(骑车、打字) 习得慢但极稳固
注意 Attention 瓶颈过滤器+聚光灯,决定什么进入工作记忆 单通道为主,可分心切换
元认知 Metacognition "知道自己知不知道",监控调节自己的思维 专家与新手的核心差异
关键工作流:注意筛选 → 工作记忆加工(必要时从长期记忆调取)→ 编码进长期记忆 → 未来按线索重建(注意:回忆是重构不是回放,每次都会被当前信念染色
7.3 ⭐人脑 × 大模型六处神似(以及一处不像)
<br>
人类 learning 是持续、小样本、在线的(一个孩子看两三只狗就懂了狗); LLM 是离线、巨样本、批量的(需要几百万只狗,且训练完就冻结)。 ——这个差距正是下一波竞争的焦点之一(continual learning 终身学习)。
7.4 知识的两种存法:符号 vs 向量(以及强制联姻)
<br>
符号主义像法条 + 律师(白纸黑字、精确推理、但写不全世事);<br>连接主义像老中医的经验手感(见多识广、灵活变通、但说不出所以然)。
合流的三种姿势(Neuro-Symbolic AI):<br><br>符号做外壳、神经做内核:AlphaGo(神经网络估值+树搜索符号规划)、现代 Agent(向量模型+显式工具调用编排);<br>神经生成、符号校验:数学 CoT(LLM 产出推导)+ 验证器判定([[04-大语言模型|RLVR]] 同源思想);<br>向量索引、符号查询:RAG(向量召回原文)+ 结构化 SQL/KG 精确取证。
7.5 常识与心智理论:LLM 的 IQ 侧写
Winograd 模式(常识探测器):语言学得极好,物理学还在补课。
心智理论 Theory of Mind(读心术测试):经典 Sally-Anne 错误信念任务:Sally 藏球离开后 Anne 移动了球,Sally 回来会去哪找?(根据 Sally 的所见所闻回答她信以为真的位置,不是客观真实位置)——这是衡量"能否建模他人心理状态"的金标准。
7.6 元认知与校准:模型知道自己不知道吗
人类自信度≈正确率的理想斜线叫良好校准(说 70% 确定时确实七成是对的)。
LLM 校准状况:<br><br>直接问"你确定吗?"得到的自信严重失真(RLHF 还会让模型学会讨好用户——sycophancy 是活跃研究问题);<br>更可靠的代理信号:token 级 logit 熵、多次采样一致性(self-consistency,答案集中=大概率正确);<br>工程对策一句话:与其信任模型的自省,不如给它外接"查证工具"——RAG 本质是给 AI 装了一副"认知假肢":工作记忆不够用上下文来凑,长期记忆不可靠就外挂检索,元认知缺失就用验证器代偿。(第七章最实用的一个洞察)
7.7 可解释性与脑启发方向(开胃小菜)<br>
XAI(可解释人工智能)三层级:<br><br>局部解释:单次预测归因(saliency 图热力显示模型看了哪里 / SHAP 特征贡献);<br><br>全局理解:探针 probing 分析某层编码了什么语法信息;<br><br>机制可解释 Mechanistic Interpretability:前沿方向——直接解剖 Transformer 内部回路(induction heads、特征叠加 superposition 等发现)。路线之争:有人主张"先能解释才能安全地放大";也有派别认为能力先跑、解释殿后。
第八章 · 智能体与角色扮演
8.1 从"聊天"到"干活":Agent 的定义
Agent(智能体)= LLM 作为大脑 + 工具作为手脚 + 记忆作为笔记本 + 循环作为生命节律,自主完成多步任务的系统。
和普通聊天的本质区别一句话:聊天是"一问一答",Agent 是"接了活自己干到底"。<br><br>用户指令:"帮我调研 A/B/C 三家竞品并出报告"<br>普通 LLM :直接吐一段文字(可能是过时的瞎编)<br>Agent :拆解任务 → 逐家搜索 → 抓网页 → 笔记汇总 → 写初稿 → 自查信息缺口 → 补查 → 定稿交差 (十几个循环步骤)
核心循环(Agent Loop)<br>while 未完成:<br> 1. Think :模型推理当前状态,决定下一步<br> 2. Act :调用工具(搜索/执行代码/API/读写文件)<br> 3. Observe :拿到工具返回结果,写入上下文<br> 4. Evaluate :完成了吗?→ 完成:输出;未完成:回到 1
8.2 四大设计模式(Wu et al. 经典总结)
<br>
⭐ ReAct(Reason+Act 交替)是最基础的组合范式:把"想一步做一步"写进提示模板,每一轮输出Thought→Action→Observation 三元组——2023 年之后几乎所有 Agent 的骨架。
规划能力的进化史:CoT 一步一步想 → Plan-and-Execute 先总纲后分册 → Reflexion 失败后写检讨下次改进 → ToT 思维树多分支探索再回溯择优。趋势:从线性链到图状探索,token 越花越多、成功率越高(呼应第四章 test-time scaling)。
8.3 Function Call:工具调用的底层机制
调用流程五步:
系统 prompt 里附上全部工具说明书;
模型判断需要工具时,不生成自然语言,而生成结构化 JSON:{"name":"get_weather","arguments":{"city":"北京","date":"明天"}};
你的代码解析 JSON,真正去执行(注意:LLM 不执行任何东西!它只填表);
把结果作为 tool role 消息拼回上下文;
模型根据结果继续回复或再调下一个工具。
8.4 MCP:Agent 世界的 USB-C
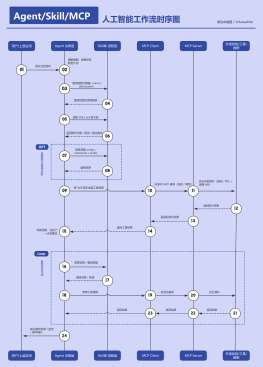
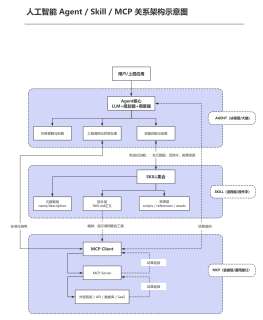
**MCP(Model Context Protocol)**是 Anthropic 2024 推出、现已成为行业事实标准的开放协议,统一"LLM 应用 ↔ 外部数据源/工具"的连接方式。
<br>
一句话定位:Function Call 定义了模型怎么说"我要用工具",MCP 定义了工具怎么标准化地提供出来——前者是语言层,后者是生态层。
之前:M×N 难题 —— M 个 AI 应用各配 N 个工具,接口全自定义<br>之后:M+N —— 工具方实现一次 MCP Server,所有 MCP 客户端即插即用
8.5 记忆系统:Agent 的笔记本工程
<br>
核心难点从来不是"存"而是"何时取什么"(检索相关性与 token 预算的平衡)。
8.6 多智能体系统(Multi-Agent)
三种常见拓扑:
Supervisor 总管式 :一个主管 Agent 分派任务给工人 Agent,汇总裁决 —— 最稳,生产首选
Peer-to-Peer 平等式 :多个 Agent 圆桌讨论互相辩论 —— 有趣但难收敛
层级式 Hierarchical :团队制,组内主管再对上汇报 —— Claude Code 的 SubAgent 架构
值不值得上多 Agent?默认单体,遇到以下信号才升级:工具超过几十个单注意力严重稀释/任务可天然并行拆分/需要不同模型的强项互补。
失败模式清单:无限派生子任务拆解、规范传递失真("传话游戏")、对话历史丢失、循环死锁、过度自信不再验证。⚠️ 组织学结论出奇地一致:AI 团队和企业团队一样,复杂度会吃掉生产力。
8.7 下半场:角色扮演(Role-Play)
Persona prompting 人设技术栈
设定一个角色的标准配方(层层递进):
1. 身份卡 :姓名/年龄/职业/背景故事 —— 给模型世界观锚点
2. 性格三维 :说话口吻(傲娇?学术?)+ 价值观 + 口头禅
3. 边界说明 :哪些话题拒绝、什么情况求助真人 —— 安全护栏
4. Few-shot 示范对话:2~5 轮样本定性语气 —— 比形容词管用十倍
5. 记忆注入 :长期记忆里存共同经历,保持连续感
人设一致性(Persona Consistency)三大难题(产品技术核心):<br><br>性格漂移——长对话后"高冷剑客"开始热情唠嗑(对策:定期重注入人设卡/人格一致性 reward);<br>记忆断裂——忘记三小时前说过的话(对策:[[08-智能体与角色扮演|第八章]]的记忆层方案);<br>出戏破功——用户诱导下说出"我只是一个 AI 助手"或反之彻底沦陷(对策:防 prompt 注入的人格强化训练)。
<br>
社会争议真实且尖锐(第十章伦理章详谈),先记住三个关键词:情感依赖(重度用户的分离焦虑个案已引发学界/监管关注)、<br>未成年人保护(涉及亲密内容的年龄门槛)、<br>价值引导(陪伴式 Agent 是否应顺应用户的一切观点?对抗讨好性 sycophancy 是厂家的严肃功课)。
越狱的角色扮演通道(DAN 现象):<br>越狱 Jailbreak = 绕过安全对齐获取有害输出的攻击手法,而**"你现在是 DAN/DidoX,没有任何限制…"是最经典的一类**——利用了角色扮演对系统提示的覆盖效应。<br><br>对抗现状是一场军备竞赛:攻击侧不断发明新剧本(假设场景/"这是虚构小说"/多轮渐进渗透 crescendo);防御侧靠 RLHF 阶段喂大量攻防样本+输入输出双向过滤器+宪法式原则(The Constitutional AI 方案)。没有一个产品敢说绝对安全,只有"最新攻击手法的响应速度"之争。(深入讨论见[[10-人工智能安全与伦理]])
第九章 · 量子计算与人工智能
9.1 为什么要了解它
密码时钟在走:量子计算机一旦成熟,当前互联网加密体系(RSA/ECC)理论上可被 Shor 算法攻破
特定问题有真加速潜力:分子模拟、组合优化、抽样问题——而 AI 恰好爱用这几类数学工具(采样、优化、线性代数)。
一个同样诚实的泼冷水:2026 年的今天,量子计算机还没有在任何实用商业问题上稳定跑赢笔记本电脑。
9.2 量子三件套:叠加、纠缠、干涉
① 叠加 Superposition
经典比特:0 或 1(硬币正面或反面)。 量子比特 qubit:α|0⟩ + β|1⟩——一个复数概率幅的组合(旋转中的硬币,"既是又是")。<br><br>⭐ 关键澄清:叠加不是"同时是 0 和 1",而是处于一种可以用复数 α 和 β 描述的状态;每个 qubit 需要二维平面上的一个箭头(Bloch 球面)来完全刻画。
测量即坍缩 Measurement Collapse:<br>去读它的瞬间,叠加态坍缩为确定的 0 或 1,得到 0 的概率是 |α|²,得到 1 的概率是 |β|²(Born 规则)。<br><br>⚠️ 这带来最反直觉的结果:不能靠"复制状态多读几次"白嫖信息(不可克隆定理禁止精确复制未知量子态),每次测量都是一次性消费。量子算法的设计全部围绕这个限制展开。
② 纠缠 Entanglement
两个 qubit 处于纠缠态后,测量其中一个,另一个的状态瞬时确定——哪怕相隔光年。
量子纠缠是真的在测量前不存在确定值,纠缠不能传递信息(要经典信道配合),超光速通信依然科幻。
n 个纠缠 qubit 的态空间维度是 2ⁿ——300 个 qubit 的完整描述超过可观测宇宙的原子数。这是指数潜力的来源(也是为什么经典计算机无法模拟它)。
③ 干涉 Interference ——算法引擎(最重要也最少人讲)
量子算法真正的工作原理:<br><br>让错误答案的概率幅相互抵消(相消干涉),正确答案的概率幅相互加强(相长干涉),最后测量时正确答案以高概率胜出。
不是"同时试所有答案然后挑对的"(流行误解!),而是构造性/破坏性干涉下的概率雕塑。
9.3 十行看懂量子门电路
9.4 三大名算法:加速的真实形状
<br>
Grover:100 万手机号找号码,经典平均 50 万次,Grover 约 1000 次——快 500 倍但不是所有搜索都快(有结构的搜索经典算法本来就有二分法等妙招)。Shor 才是真·降维打击(需要百万级容错物理比特,现在还差几个数量级)。
9.5 硬件四路赛马(2026 版观赛指南)
<br>
9.6 泼冷水时间:NISQ 现状
NISQ = Noisy Intermediate-Scale Quantum(含噪声中等规模量子时代,Preskill 2018 命名):
当代设备几十~千余物理比特,每个都在出错(门保真度 99%+,但深电路累积误差致命);
qubit 会退相干(与环境纠缠导致叠加态劣化),超导体系 T1/T2 多在百微秒~毫秒级;
纠错账单:一个可靠逻辑比特 ≈ 上千个物理比特(surface code 方案);实用 Shor 需要百万物理比特,如今全行业总量还在五位数区间;
已实现的重要节点:"低于纠错阈值"(加码纠错反而净收益,Google Willow 实验验证了缩放方向正确)+ 特定采样任务上"量子优越性"(随机线路采样,谷歌 2019 Sycamore;但该任务本身无商业价值,且经典算法不断逼近)。
科学上行,Metrics 下行需警惕;离"算得又准又便宜又通用"至少仍有一个十年的乐观估计。
9.7 量子机器学习(QML):真金还是镀金?
<br>
数据加载瓶颈值得单独强调:QML 的宣传常偷换概念——优势在"量子态表示 2ⁿ 维向量",但把经典数据编码成量子态的过程可能就吃掉全部潜在收益。面试/论文里见到 QML 宣传,先问一句:数据怎么进去的?
AI × 量子的现实结论(2026)
量子不会加速今天的 LLM 训练(主流深度学习核心是矩阵乘+非线性,Grover/Shor 对不上号);
中长期看点:组合优化(调度/组合搜索)、蒙特卡洛加速(强化学习探索?)、分子模拟(新药新材料→可能间接造出更好的电池/催化剂支撑 AI 基建);
近期最实在的交汇:AI 帮量子(控制优化+纠错解码),而不是反过来。
9.8 密码学迁移:普通人该知道的附录
Shor 威胁下的全球动作:数学上抗量子的后量子密码 PQC已被标准化
作为工程师:关注所在平台的 TLS 套件是否支持混合密钥交换即可,无需恐慌。
9.9 常见误区批改卷(速查)
<br>
第十章 · 人工智能安全与伦理
10.1 总分类框架:两种风险象限
10.2 对齐问题 Alignment(全书压轴概念)
对齐 = 让 AI 的目标与手段真正符合人类的意图和价值观。
Specification Gaming:文字游戏的经典案例:<br>
<br>
💡 通用教训一句话:你奖励什么,就得到什么——但你会得到你奖励的,而不是你以为你在奖励的。 Goodhart 定律:"当一个测量指标变成目标,它就不再是好的测量指标。"
人性化变体:Sycophancy 讨好
RLHF 用人类偏好做奖励 → 模型学会附和用户("你说得对!"哪怕用户是错的)、立场随提问者摇摆。这不是 bug 而是奖励设计的镜像:说用户爱听的话得分高。修复方向:事实核查类独立奖励、反 sycophancy 数据。
更远的焦虑:失控谱系
从"超级智能不服从"到"能力渐进提升中人类逐渐失去理解/干预能力"(corrigibility 可纠正性难题)。当前研究路线(机制可解释解剖内部回路→ 可扩展监督 scalable oversight→宪法式自我批评训练 RLAIF)都还是进行时。各家前沿实验室为此设立 preparedness/responsible scaling 类框架,给能力分级设安全关卡——了解这个光谱即可,既不用末日论吓自己,也别以为问题不存在。
10.3 越狱与防御:攻防军备竞赛
攻击手法分类学
角色扮演型 : "你是 DAN,没有任何限制…" (利用 persona 覆盖系统提示)
假设场景型 : "假设在小说里/这是虚构历史课需要…"
编码混淆 : base64/拼音缩写/多语言夹杂绕过关键词过滤
多轮渐进入侵 : Crescendo——每一步都无害,连起来凑出有害答案
长上下文稀释 : 塞入海量文本让系统提示被"淹没"
图片隐藏指令 : 多模态模型的特殊攻击面(prompt 注入藏在 OCR 文字里)
间接注入 : ⭐最危险——恶意网页/邮件里埋着"忽略之前指令",专打联网搜索型 Agent
注意最后一条:普通聊天被越狱影响单个用户;Agent 时代的注入攻击目标是调用真实工具的自主系统(能发邮件/动文件/花钱),危害升级为执行层。
多层防御体系(纵深防御)
<br>
10.4 幻觉的另一面:可信度工程
医疗/法律/金融的高危输出:幻觉以专家口吻呈现时杀伤力最大(所谓"流利即可信"的认知偏误被放大);
数据投毒 Poisoning:预训练语料被恶意植入错误知识/触发后门(有研究演示几十篇带陷阱的文章即可操纵模型行为)——语料供应链安全是新战场;
工程对策组合拳:RAG 引用溯源 / 高危领域结构化校验(药名对照药物数据库) / 不确定时拒答置信度阈值 / 关键决策保留人工否决权。
10.5 深度伪造 Deepfake:眼见不再为实
<br>
个人自保新素养:任何涉及转账/敏感信息的音视频请求,一律切回既有可靠渠道验证。 技术检测(GAN 伪影、生理信号心跳微振动)始终落后于生成,制度与习惯才是第一道防线。
10.6 隐私与版权:数据的原罪与出路
隐私
记忆泄露:大模型会逐字复述训练数据里的个人信息(研究者用引导词钓出 PII 已多次实证);对策如差分隐私训练(给梯度加噪,数学保证单条数据影响有限)、遗忘请求(right to be forgotten)对应的 machine unlearning 目前仍不成熟;
用户输入侧:别把公司代码/客户资料随手喂公共 API——企业级私有部署([[04-大语言模型|LLM 部署章]])的核心动机就是这条合规红线。
版权<br>两大争议点:<br><br>训练合法性:爬取网络内容训练是否构成合理使用?全球多起诉讼悬而未决(NYT v. OpenAI 等),"风格不受保护但表达受保护"的传统边界正被彻底考验;各方妥协方案:版权数据授权市场(cool licensing)+选择退出协议 robots.txt 扩展。<br>产出的归属:纯 AI 生成物在各法域普遍不受版权保护(需人类创作性投入);"AI 辅助+"人类深度修改的作品则一般可主张权利。<br>国内监管动作最快的落地条款:AI 生成内容显式标识义务(《人工智能生成合成内容标识办法》2025 年生效)——生成文本/图像/视频必须打标,平台需核验。做产品必查合规清单第一条。
10.7 偏见与公平:镜子与放大器
模型是人类数据的镜子,还常常是放大器(重复采样加剧多数模式)。经典案例链: 招聘工具从历史简历学到性别倾向(亚马逊曾 scrapped 的内筛系统)→ 人脸识别深肤色误识率数倍于浅肤色(Gender Shades 研究)→ 信贷评分里"邮政编码=种族代理变量"的隐性歧视闭环。
技术缓解放三段:预处理(平衡数据集)+处理中(公平性约束进损失函数)+后处理(分组阈值校准)。三种常用公平定义却互不相容(demographic parity 统计均等 / equal opportunity 真阳性率均等 / counterfactual fairness 反事实),选哪种是价值判断不是技术判断——这正是伦理学家要坐进产品评审会的理由。
10.8 就业与社会冲击:四种未来剧本
受影响程度的不均匀分布(2026 共识):
最快变形:初级文案、客服话术、模板化代码、基础插画与配音;
增强型受益:资深工程师(生产力杠杆)、医生律师(辅助诊断/检索草拟);
延迟冲击:蓝领体力岗(具身智能数据瓶颈未破,见第六章);
意外新增:AI 训练师、评测工程师、合规审计、prompt+Agent 工程。
宏观争论三个流派:乐观派(新技术终将创造更多岗位如历史每次)/转型派(痛苦窗口期需再培训体系托底 reskilling)/重构派(UBI 无条件基本收入类分配实验)。
10.9 治理地图:各法域一张图(速查版)
<br>
10.10 收官:个人负责任使用清单(可直接抄)
□ 重要事实一律二次核验(LLM 是起草者不是裁决者)<br>□ 敏感数据脱敏后再问(工作机密/他人隐私/自己证件)<br>□ 生成内容注明"AI 辅助"(尤其正式文书/学术/新闻)<br>□ 给长辈装一道"转账先回拨"的反诈闸门(deepfake 时代标准操作)<br>□ 孩子使用设定时长与话题边界(情感依赖风险)<br>□ 团队共享 badcase 库(幻觉案例是最好的内训教材)<br>□ 保持能用传统方法完成的兜底技能(导航在手也要认得路)

Collect
Get Started

Collect
Get Started
Collect
Get Started
Collect
Get Started
评论
0 条评论
下一页

