微服务架构演进历程
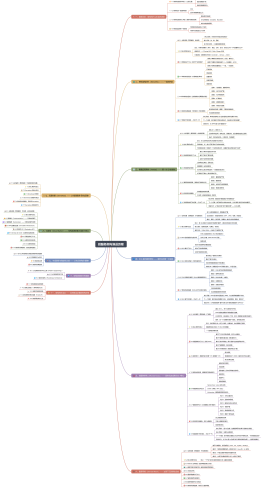
2026-09-23 14:05:47 0 举报天天写微服务,面试被问“为啥不继续用单体”却哑口无言? 这份脑图带你盘透从单体、SOA、微服务到Service Mesh和云原生的真实演进因果链。 只讲每代架构填了啥坑、又挖了啥新坑。 不管你是准备跳槽的后端,还是做技术选型的Leader,顺着图捋一遍,彻底搞懂架构演进的底层逻辑,下次技术评审和面试跟大佬对线绝对不怯场!
架构师
云原生
系统架构设计
微服务架构
架构演进
模板推荐
作者其他创作
大纲/内容
🎯 一、演进总览:架构为什么永远在演进
🔥 1.1 架构演进的根本动力(三股力量)
业务复杂度的增长
功能越来越多:从"能下单"到"下单+支付+物流+售后+营销+会员"
业务规则越来越复杂:优惠券叠加、跨店满减、预售、拼团
驱动力本质:业务价值诉求倒逼技术能力升级
团队规模的扩张
3 人团队:一个代码库随便改,沟通成本几乎为零
300 人团队:改一行代码要协调 10 个团队,协作成本爆炸
驱动力本质:康威定律——系统结构必然趋同于组织结构
性能与规模的压力
日订单从几百到亿级,单机扛不住 → 必须分布式
用户从同城到全球,延迟敏感 → 必须多地域部署
驱动力本质:物理极限倒逼架构从集中走向分布
🕊️ 1.2 架构演进一直是持续的
含义
架构不是"一次设计到位"的终点,而是"持续演进"的过程
每一代架构都会"死去"(被淘汰),但其中的精华会"重生"在下一代
例:单体的"简单性"在 Serverless 中以新形式回归
反对"架构原教旨主义"
没有"最好的架构",只有"最适合当前阶段的架构"
盲目追新(单体强上微服务)和固步自封(亿级用户还用单体)都是灾难
⚖️ 1.3 架构演进的核心矛盾(贯穿全程的权衡)
复杂度守恒定律
复杂度不会消失,只会转移
例:微服务把"代码复杂度"转移成了"分布式复杂度"
架构师的职责:让复杂度转移到"可管理"的地方
分与合的辩证(分久必合,合久必分)
分:单体 → 微服务(为了独立演进、独立扩展)
合:微服务 → 服务网格/Serverless(把通用能力下沉到基础设施)
本质:在"业务敏捷性"和"基础设施复用性"之间寻找平衡
成本与收益的权衡
每一代架构都有"隐性成本":运维、学习、调试、一致性
架构师必须算清:引入新技术的收益是否大于其成本
🧭 1.4 架构选型的第一性原理
判断是否该演进的三个信号
信号1:发布频率下降(改一个小功能要等很久才能上线)
信号2:故障影响面扩大(一个模块挂导致全站不可用)
信号3:扩展遇到瓶颈(只能整体扩容,无法针对性扩容)
判断不该演进的三个信号
团队规模还小(过早微服务化 = 自找麻烦)
业务模型还不稳定(频繁变动时拆分等于返工)
没有基础设施支撑(没有 DevOps 上微服务 = 运维灾难)
🏛️ 二、单体架构时代(Monolithic)—— 一切的开始
📖 2.1 业务背景(贯穿案例:创业期)
3 名工程师,目标是"尽快验证商业模式"
核心诉求:快、省、简单
日订单几百单,一台服务器绰绰有余
💡 2.2 核心思想与定义
定义:所有功能模块(用户、商品、订单、支付)打包在【同一个可部署单元】中
一个代码仓库
一次构建产出一个 war/jar 包
部署在一台(或少数几台做负载均衡的)服务器上
典型形态:一个 Spring MVC / Rails / Django 应用
分层结构:通常按技术分层(Controller → Service → DAO)
🎯 2.3 单体解决了什么(相对于"没有架构")
提供了清晰的代码组织方式(分层、模块化)
提供了完整的本地事务能力(一个数据库,ACID)
提供了简单的部署模型(一个包,一次部署)
✅ 2.4 单体架构的优势(不要妖魔化单体)
开发简单
一个 IDE 打开全部代码,改哪里一目了然
模块间调用是本地方法调用,无需考虑网络、序列化
测试简单
端到端测试容易,无需启动多个服务
部署简单
一个包部署一次,无需考虑服务编排、依赖顺序
性能开销低
进程内调用,无网络延迟、无序列化开销
事务简单
本地数据库事务即可保证一致性
⚠️ 2.5 单体架构的困境(当规模增长后暴露的问题)
困境1:代码膨胀,理解成本高
从 1 万行到 100 万行,新人上手从 1 天变成 1 个月
模块边界模糊,改订单代码可能误伤支付逻辑
困境2:协作冲突严重
30 人改同一个代码库,合并冲突成为日常
发布要协调所有人,"发布窗口"成为瓶颈
困境3:技术栈被锁死
整个应用只能用一种语言、一个框架
想尝试新技术(如用 Go 重写高性能模块)几乎不可能
困境4:扩展性差
只能整体扩容(即使只有"下单"模块压力大,也要复制整个应用)
资源浪费严重
困境5:故障影响面大
一个模块内存泄漏 → 整个应用崩溃 → 全站不可用
缺乏隔离性
困境6:持续交付困难
任何小改动都要重新构建、部署整个应用
发布周期长,无法做到每天多次发布
🎯 2.6 架构师决策指南:何时该用 / 不该用单体
该用单体的场景(重要!不要盲目微服务)
初创期:业务模型未验证,需要快速迭代
小团队:少于 10 个工程师
简单业务:功能单一,复杂度低
原则:"Monolith First"——先从单体开始,等真正需要时再拆
不该用单体的场景
团队规模超过一定阈值(如 30+ 人协作一个代码库)
业务模块间复杂度差异极大(有的需要高并发,有的几乎不变)
需要独立扩展不同模块
🔮 2.7 单体留下的问题 → 引出下一代
核心矛盾:单体的"整体性"与"业务/团队的多样化需求"冲突
下一个问题:能不能把不同的业务拆开,各自独立开发和部署?
演进方向:从"水平分层"走向"垂直拆分"
🏢 三、垂直应用架构(Vertical)—— 第一次"分"的尝试
📖 3.1 业务背景(贯穿案例:成长期初期)
团队从 3 人涨到 30 人
业务线开始出现:电商主站、营销活动、后台管理各自独立发展
痛点:所有业务挤在一个单体里,互相拖累
💡 3.2 核心思想与定义
定义:按【业务线/应用】维度进行纵向拆分
每个业务线一个独立的应用(独立的代码库、独立的部署单元)
例:电商主站、营销系统、后台系统各自独立
形象比喻:从"一栋大平层"变成"几栋独立的楼"
与单体的区别:单体是"一个应用内部分层",垂直是"按业务拆成多个应用"
🎯 3.3 垂直架构解决了什么
解决了单体内部的协作冲突
不同业务线各自维护各自的代码库
发布互不影响
解决了部分扩展性问题
流量大的业务线可以单独扩容
实现了业务的初步隔离
营销系统挂了,不影响主站下单
✅ 3.4 垂直架构的优势
业务线独立演进,团队自治
故障隔离(业务线级别)
技术栈可以按业务线选择(一定程度的灵活性)
扩展性优于单体(按业务线扩容)
⚠️ 3.5 垂直架构的困境("烟囱式"架构的代价)
困境1:重复建设严重
每个业务线都要自己实现"用户登录""支付""短信通知"
同样的轮子被造了 N 遍
困境2:数据孤岛
每个业务线有自己的数据库,数据不互通
想做一个"用户全景画像"发现数据分散在 5 个系统
困境3:业务线之间调用困难
业务线之间需要交互时,缺乏标准的通信方式
往往通过数据库直连、文件交换等"土办法"
困境4:资源利用率低
每个业务线都预留足够的资源,但大部分时间闲置
烟囱林立,资源无法共享
🎯 3.6 架构师决策指南
该用垂直架构的场景
业务线之间相对独立,交互不多
团队按业务线组织,需要独立交付
不该用(或该继续演进)的信号
业务线之间需要大量共享能力(用户、支付、消息)
重复建设导致维护成本飙升
数据打通的需求越来越强烈
🔮 3.7 垂直架构留下的问题 → 引出下一代
核心矛盾:烟囱式的"重复建设"和"数据孤岛"
下一个问题:能不能把公共能力抽出来,作为"服务"供所有业务线复用?
演进方向:从"各自为政"走向"服务共享"——SOA 登场
🌐 四、SOA 面向服务架构 —— 服务化的第一次浪潮
📖 4.1 业务背景(贯穿案例:扩张期初期)
多个业务线烟囱林立,重复建设严重
企业级诉求:打通异构系统(ERP、CRM、电商、供应链)
痛点:每接一个新系统,就要做一堆点对点的定制集成
💡 4.2 核心思想与定义
定义:将【公共能力】抽取为可复用的"服务",通过标准化接口对外提供
服务是粗粒度的、自包含的业务能力单元
例:用户服务、支付服务、库存服务,供所有业务线调用
核心理念:服务的复用、松耦合、标准化
诞生年代:1990s-2000s,企业级 IT 集成的产物
🏗️ 4.3 SOA 的关键组件与技术栈
ESB 企业服务总线(SOA 的灵魂组件)
定位:所有服务间通信的"中央枢纽"
职责:消息路由、协议转换、格式转换、服务编排、监控
比喻:服务世界的"中央车站",所有车都要经过这里
问题:ESB 成为单点、成为瓶颈、成为"上帝对象"
技术三件套(Web Service 标准)
SOAP:基于 XML 的消息协议(冗长、重量级)
WSDL:服务描述语言(定义服务的接口)
UDDI:服务注册与发现目录
服务治理
服务的注册、发现、监控、版本管理
🎯 4.4 SOA 解决了什么
解决了垂直架构的重复建设
公共能力(用户、支付)抽成服务,所有业务线复用
解决了异构系统集成
通过 ESB 的协议转换,打通不同技术栈的系统
实现了服务的标准化
统一的接口规范,降低集成成本
✅ 4.5 SOA 的历史贡献(不要全盘否定)
首次确立了"服务化"的思想
"把能力做成服务供复用"——这个思想被微服务完整继承
推动了接口标准化
为后来的微服务奠定了理论基础
关键认知:微服务是 SOA 思想的"进化",不是"否定"
⚠️ 4.6 SOA 的困境与衰落(为什么被微服务取代)
困境1:ESB 成为单点瓶颈和故障点
所有流量经过 ESB,ESB 挂了全挂
ESB 越来越重,承载了太多业务逻辑(路由、编排、转换)
困境2:服务粒度太粗
SOA 的服务往往是"粗粒度"的(一个服务对应一个大业务域)
改一个功能还是要动一大块
困境3:技术栈太重、太复杂
SOAP + XML + WSDL 极其冗长
开发、调试、性能都不友好
困境4:治理集中化
治理逻辑集中在 ESB,与"去中心化"的互联网演进方向相悖
困境5:实施成本极高
企业级 SOA 落地往往耗时数年,投入巨大
🎯 4.7 架构师决策指南(SOA 在今天还有价值吗)
仍有价值的场景
企业级集成:需要打通大量异构遗留系统
需要集中式的服务编排和协议转换
应该用微服务替代的场景
互联网高并发场景
需要细粒度、独立部署的服务
追求轻量级、高性能的通信
🔮 4.8 SOA 留下的问题 → 引出下一代
核心矛盾:SOA 的"集中式重治理(ESB)"与"互联网敏捷需求"冲突
下一个问题:能不能去掉笨重的 ESB,让服务更细、更轻、更独立?
演进方向:从"粗粒度服务+集中总线"走向"细粒度微服务+去中心化"
🔬 五、微服务架构(Microservices)—— 服务化的成熟形态 ★核心
📖 5.1 业务背景(贯穿案例:扩张期)
团队 300 人,多个业务线并行开发
SOA 的粗粒度服务开始拖慢迭代速度
日订单百万,部分模块(下单、秒杀)需要独立的高并发能力
痛点:改一个功能要协调多个团队,发布窗口紧张
💡 5.2 核心思想与定义
定义:将应用拆分为一组【小型的、松耦合的、独立部署的】服务
每个服务围绕【特定业务能力】构建
每个服务可独立开发、独立测试、独立部署、独立扩展
微服务的核心特征(与 SOA 对比理解)
服务粒度更细:一个服务只做一件事(如"订单服务"只管订单)
去中心化治理:没有 ESB,服务间直接通信(点对点)
去中心化数据管理:每个服务拥有自己的数据库(Database per Service)
轻量级通信:HTTP/REST、gRPC,而非 SOAP
独立部署:改一个服务只需重新部署这一个服务
一个经典的判断标准
"一个微服务能否由一个小团队(2 pizza team,6-10人)独立维护?"
🎯 5.3 微服务解决了什么(相对 SOA)
解决了 ESB 的单点瓶颈(去中心化通信)
解决了服务粒度过粗(细粒度拆分)
解决了技术栈锁定(每个服务可自由选择技术栈)
解决了部署耦合(独立部署)
解决了扩展粗粒度(按服务独立扩展)
🏗️ 5.4 服务拆分:微服务设计的第一步(最难的一步)
拆分原则
单一职责:一个服务只做一件事,做好一件事
高内聚低耦合:服务内部紧密相关,服务之间依赖最少
围绕业务能力拆分(而非技术层)
演进式拆分:先粗后细,不要一次拆到位
领域驱动设计(DDD)是拆分的方法论基石
限界上下文(Bounded Context):每个微服务对应一个限界上下文
聚合(Aggregate):数据一致性的边界
上下文映射(Context Mapping):服务间的关系
核心认知:拆分的质量取决于对业务领域的理解深度
拆分的常见误区
误区1:拆得太细(一个 CRUD 一个服务)→ 运维爆炸
误区2:按技术层拆(一个用户表对应一个服务)→ 一个功能跨 10 个服务
误区3:拆分时不考虑数据边界 → 分布式事务满天飞
误区4:一步到位拆分 → 风险极高,应该渐进演进
🔧 5.5 服务治理体系(微服务的"基础设施")
服务注册与发现
问题:服务实例动态变化(扩容、缩容、故障),调用方如何找到对方?
模式1:客户端发现(调用方自己查询注册中心)
模式2:服务端发现(通过负载均衡器,如 Nginx)
主流组件:Eureka、Consul、Nacos、Zookeeper
关键机制:心跳检测、健康检查、服务的注册/注销
负载均衡
作用:将请求分发到多个服务实例
算法:轮询、加权轮询、随机、最少连接、一致性哈希
客户端负载均衡:Ribbon / Spring Cloud LoadBalancer
服务端负载均衡:Nginx、LVS
服务容错(分布式环境的必修课)
超时控制:调用必须有超时,避免无限等待
重试机制:失败重试,但要注意幂等性
熔断器(Circuit Breaker)
三种状态:闭合(正常)→ 打开(熔断)→ 半开(试探)
作用:当下游服务持续失败时,快速失败,避免雪崩
代表:Hystrix、Sentinel、Resilience4j
限流:控制流量,保护服务(令牌桶、漏桶算法)
降级:核心功能保证可用,非核心功能暂时关闭
舱壁隔离(Bulkhead):用线程池/信号量隔离不同依赖,避免一个依赖拖垮全局
服务网关
定位:系统的统一入口
职责:路由、鉴权、限流、日志、协议转换
代表:Spring Cloud Gateway、Zuul、Kong、APISIX
配置中心
问题:几百个服务的配置如何统一管理、动态更新?
代表:Spring Cloud Config、Nacos、Apollo
能力:配置集中管理、动态推送、灰度发布配置
服务间通信
同步通信:HTTP/REST(通用)、gRPC(高性能、强类型)
异步通信:消息队列(Kafka、RocketMQ、RabbitMQ)
选型:强一致诉求用同步,解耦/削峰用异步
🌍 5.6 微服务的技术生态
Spring Cloud(Java 生态主流)
一站式解决方案:网关、注册中心、配置中心、熔断、链路追踪
特点:侵入式(治理逻辑嵌入业务代码,以 SDK/注解形式)
Dubbo(阿里,RPC 为主)
高性能 RPC 框架
适合内部服务间的高性能调用
Kubernetes(服务编排的事实标准)
服务的部署、扩缩容、自愈
微服务 + K8s 是黄金组合
⚠️ 5.7 微服务的代价(必须清醒认识的"暗面")
代价1:分布式复杂性
网络不可靠:调用可能超时、失败、重复
数据一致性难:跨服务无法用本地事务
调试困难:一个请求跨 10 个服务,问题定位难
代价2:运维成本剧增
从运维 1 个应用变成运维 100 个服务
需要完善的 CI/CD、监控、日志、链路追踪体系
没有 DevOps 基础设施,微服务 = 灾难
代价3:服务拆分的认知负担
拆分不当比不拆更糟
需要深厚的领域建模能力
代价4:性能开销
进程间调用替代了进程内调用,有网络 + 序列化开销
代价5:测试复杂度上升
集成测试、契约测试变得复杂
代价6:数据一致性挑战
每个服务独立数据库,跨服务事务难处理
🎯 5.8 架构师决策指南:何时上微服务
该上微服务的信号
团队规模大(多团队并行开发,协作成本高)
业务模块需要独立扩展(部分模块高并发)
需要独立部署和快速迭代
已有成熟的 DevOps 基础设施
不该上微服务的信号
团队小(< 10 人)
业务模型不稳定(频繁变动)
缺乏运维能力(没有监控、没有自动化部署)
单纯为了"技术先进性"而上
架构师的忠告
"如果你不确定是否需要微服务,那你大概率不需要"
微服务是手段,不是目的,目的是解决规模化协作和扩展问题
🔮 5.9 微服务留下的问题 → 引出下一代
核心矛盾1:侵入式治理(治理逻辑写死在每个服务的代码里)
升级熔断器版本 → 要改几百个服务的代码 → 逐个重新发布
多语言服务 → 每种语言都要实现一套治理 SDK(重复造轮子)
核心矛盾2:治理与业务耦合
业务开发者要关心熔断、限流、重试,无法专注业务
下一个问题:能不能把治理能力从业务代码中剥离出来,下沉到基础设施?
演进方向:从"SDK 侵入式治理"走向"基础设施级治理"——服务网格登场
🕸️ 六、服务网格(Service Mesh)—— 治理下沉到基础设施
📖 6.1 业务背景(贯穿案例:平台期初期)
数百个微服务,多语言混合(Java、Go、Python、Node.js)
痛点1:每种语言都要维护一套治理 SDK(Java 有、Go 没有)
痛点2:升级治理组件要改所有服务代码
痛点3:业务开发者被迫成为"半个中间件工程师"
💡 6.2 核心思想与定义
定义:一个专门处理【服务间通信】的【基础设施层】
将治理能力(负载均衡、熔断、限流、监控、加密)从业务代码中剥离
下沉到基础设施,业务代码无感知
核心理念:"把服务治理变成基础设施的一部分"
类比:就像城市的地下的"管网"(水电煤),应用无需关心,开箱即用
🏗️ 6.3 Sidecar 边车模式(服务网格的核心形态)
原理:每个服务实例旁边部署一个"代理"进程(Sidecar)
所有进出服务的流量,都被 Sidecar 代理接管
服务本身不需要知道治理逻辑的存在
形象比喻
服务 = 主驾驶(专注开车/业务)
Sidecar = 边三轮的挎斗(负责导航、路况、加油/治理)
关键优势
业务代码零侵入:治理逻辑在 Sidecar 里
多语言统一:不管服务用什么语言,Sidecar 都能接管
独立升级:升级治理逻辑只需升级 Sidecar,不动业务代码
🏛️ 6.4 数据平面与控制平面(服务网格的两层架构)
数据平面(Data Plane)
由所有 Sidecar 代理组成
职责:实际转发、处理服务间的网络流量
代表:Envoy(高性能代理)
控制平面(Control Plane)
管理所有 Sidecar 的"大脑"
职责:下发配置、服务发现、证书管理、策略管理
代表:Istio
两者关系:控制平面制定规则,数据平面执行规则
🛠️ 6.5 主流技术栈
Istio:最主流的服务网格控制平面(功能全面,但较复杂)
Envoy:最主流的数据平面代理(C++,高性能)
Linkerd:轻量级服务网格(简单易用,资源占用低)
选型权衡:功能全面选 Istio,轻量简单选 Linkerd
🎯 6.6 服务网格解决了什么
解决了侵入式治理的问题(治理下沉,业务无感)
解决了多语言治理的重复建设(统一的 Sidecar 接管所有语言)
解决了治理组件升级的发布难题(升级 Sidecar 即可)
实现了治理关注点的彻底分离(业务管业务,网格管通信)
✅ 6.7 服务网格带来的能力
流量管理:细粒度的流量控制、灰度发布、金丝雀发布、故障注入
安全:服务间的 mTLS 加密、细粒度访问控制
可观测性:自动采集指标、日志、链路追踪(无需业务埋点)
策略执行:限流、配额、访问控制
⚠️ 6.8 服务网格的代价与挑战
代价1:性能开销
每次调用多经过一层 Sidecar 代理,增加延迟(通常几毫秒)
代价2:运维复杂度
引入了控制平面这一新的复杂组件
Istio 的学习曲线陡峭
代价3:资源消耗
每个服务实例都多一个 Sidecar,资源占用增加
代价4:团队能力要求
需要专门的平台团队来维护服务网格
🎯 6.9 架构师决策指南:何时引入服务网格
该引入的信号
微服务数量多(几十上百个)
多语言技术栈
治理组件频繁升级,发布成本高
有专门的平台/基础设施团队
不该引入的信号
微服务数量少(< 20 个)
技术栈单一(只有 Java,SDK 治理够用)
团队规模小,无力维护复杂基础设施
架构师的忠告
服务网格是"锦上添花",不是"雪中送炭"
先把微服务做好,再考虑服务网格
🔮 6.10 服务网格的定位与演进方向
定位:"下一代微服务"的治理形态
演进方向
与 Kubernetes 深度融合(Sidecar 作为 Pod 的一部分)
Sidecarless(无 Sidecar)探索:如 Istio Ambient Mesh,降低开销
与 Serverless 结合,形成更抽象的运行时
☁️ 七、无服务器(Serverless)—— 从"管理服务"到"免运维"
📖 7.1 业务背景(贯穿案例:平台期的特定场景)
一些业务特点:流量波动极大(如大促秒杀、事件触发处理)
痛点1:为了应对峰值,平时也要预留大量资源(资源浪费)
痛点2:运维几百个微服务的服务器,成本高昂
诉求:能不能"只管写代码,不管服务器"?
💡 7.2 核心思想与定义
定义:开发者只需编写和部署【代码/函数】,无需管理服务器
服务器的配置、扩缩容、运维全部由云平台自动处理
按【实际调用次数和执行时间】计费,而非按预留资源计费
核心理念:"Serverless ≠ 没有服务器",而是"开发者无需关心服务器"
类比:从"自己买车养车"(管理服务器)到"打车"(按需使用,按里程付费)
🏗️ 7.3 Serverless 的两大支柱
FaaS 函数即服务(Function as a Service)
定义:以"函数"为单位的代码执行平台
开发者写一个函数,上传,平台负责运行
触发方式:HTTP 请求、定时任务、消息事件、文件上传
代表:AWS Lambda、阿里云函数计算 FC、腾讯云 SCF
典型场景:图片处理、事件回调、定时任务、轻量级 API
BaaS 后端即服务(Backend as a Service)
定义:云厂商提供的托管后端服务
例:托管数据库(DynamoDB)、托管认证、托管消息队列、托管存储(S3)
开发者无需运维这些后端组件
完整 Serverless = FaaS + BaaS
✅ 7.4 Serverless 的优势
优势1:免运维
无需关心服务器的配置、补丁、扩容
运维工作量大幅降低
优势2:弹性伸缩
自动根据流量扩缩容,从 0 到几千个实例
应对突发流量的能力极强
优势3:按需计费,成本优化
没有请求时不收费(缩容到 0)
适合流量波动大、有明显峰谷的业务
优势4:快速上线
专注业务逻辑,无需搭建基础设施
适合快速验证想法
⚠️ 7.5 Serverless 的局限与挑战
局限1:冷启动问题
问题:函数长时间没被调用,实例被回收;下次调用要重新启动,延迟高
影响:首次调用可能几百毫秒到几秒
缓解:预热(保持实例活跃)、预留实例(但又回到付费预留)
局限2:状态管理困难
函数是无状态的、短暂的,不能存本地状态
状态必须外置(到数据库、缓存),增加复杂度
局限3:执行时长限制
函数通常有最大执行时间限制(如 15 分钟)
不适合长时间运行的任务
局限4:厂商锁定(Vendor Lock-in)
深度依赖某云厂商的 FaaS 平台
迁移成本高
局限5:调试和监控困难
分布式 + 无服务器,问题定位更复杂
局限6:不适合复杂、长连接、高并发的核心系统
函数更适合"事件驱动的轻量任务",不适合重逻辑的长服务
🎯 7.6 架构师决策指南:何时用 Serverless
适合 Serverless 的场景
事件驱动型任务(图片处理、文件转换、事件回调)
流量波动极大的场景(大促、活动)
定时任务、后台作业
快速原型验证
轻量级、无状态的 API
不适合 Serverless 的场景
长时间运行的任务
需要低延迟、稳定响应的核心链路(冷启动影响)
重度有状态的服务
对厂商锁定敏感的场景
架构师的忠告
Serverless 不是微服务的替代品,而是补充
合理混合使用:核心链路用微服务,边缘/事件任务用 Serverless
🔮 7.7 Serverless 的演进方向
冷启动优化:更快的启动技术(如 MicroVM、Firecracker)
状态管理:与有状态服务(数据库、缓存)更好结合
与容器融合:如 Knative,在 K8s 上实现 Serverless
多云/混合云 Serverless,降低厂商锁定
🐳 八、云原生(Cloud Native)—— 架构演进的集大成者 ★核心
📖 8.1 业务背景(贯穿案例:平台期,全球化部署)
数千工程师,亿级用户,多地域部署
痛点1:服务数量庞大,手工部署/运维不现实
痛点2:环境不一致(开发、测试、生产环境差异导致"在我机器上是好的")
痛点3:需要极致的弹性和资源利用率
诉求:一套统一的、自动化的、弹性的基础设施平台
💡 8.2 核心思想与定义
定义(CNCF 云原生计算基金会)
利用容器、微服务、服务网格、不可变基础设施、声明式 API 等技术
构建【容错、易管理、可观测】的松耦合系统
结合自动化,让工程师以最小代价做出高频、可预期的重大变更
核心理念:为云而生,充分利用云的弹性、分布式、自动化能力
关键认知:云原生不是单一技术,而是一套"技术体系 + 方法论"
📦 8.3 容器化(Containerization)—— 云原生的基石
容器解决的核心问题:环境一致性
痛点:"在我开发机器上是好的,怎么到生产就挂了?"
原因:环境差异(依赖库版本、配置不同)
解决:把应用 + 依赖 + 配置打包成镜像,到哪运行都一样
Docker:容器化的事实标准
镜像(Image):应用的打包产物,不可变
容器(Container):镜像运行的实例
仓库(Registry):镜像的存储和分发(如 Docker Hub)
容器 vs 虚拟机(理解容器的轻量)
虚拟机:每个虚拟机有完整的操作系统,重、启动慢
容器:共享宿主机内核,只打包应用和依赖,轻、启动快(秒级)
容器更适合微服务的细粒度部署
☸️ 8.4 容器编排(Kubernetes)—— 云原生的操作系统
为什么需要编排
几百上千个容器,如何部署、扩缩容、故障恢复?
手工管理不现实,需要自动化编排
Kubernetes(K8s):容器编排的事实标准
定位:容器的"操作系统",管理容器的生命周期
K8s 核心概念(架构师必懂)
Pod:最小的部署单元,包含一个或多个容器
Deployment:管理 Pod 的副本数、滚动更新
Service:为一组 Pod 提供稳定的访问入口
Namespace:资源隔离
ConfigMap / Secret:配置和敏感信息管理
K8s 的核心能力
自动部署和回滚
自动扩缩容(根据 CPU/内存/自定义指标)
自愈:容器挂了自动重启,节点挂了自动迁移
服务发现和负载均衡
滚动更新:不停机更新应用
🧱 8.5 不可变基础设施(Immutable Infrastructure)
核心思想
服务器/容器一旦部署,就不再修改
需要变更时,不是"改原来的",而是"构建新镜像替换旧的"
对比可变基础设施
可变:登录服务器,手动改配置(容易漂移、难追溯)
不可变:改配置 → 构建新镜像 → 替换部署(环境一致、可追溯)
价值
环境一致性:避免"配置漂移"
可回滚:出问题直接回滚到上一个镜像
可审计:每次变更都有对应的镜像版本
📜 8.6 声明式 API(Declarative API)
核心思想
你声明"期望状态"(我要 3 个副本),而不是"操作步骤"(先启动1个,再启动2个)
系统自动将"实际状态"向"期望状态"收敛
对比命令式
命令式:一步步告诉系统"怎么做"
声明式:告诉系统"要什么",系统自己想办法达到
在 K8s 中的体现
用 YAML 声明期望状态(如"我要 3 个副本")
K8s 的控制器持续工作,确保实际状态 = 期望状态
副本少了自动补,多了自动删
价值:自动化、自愈、可预期
🔄 8.7 DevOps 与 CI/CD(云原生的实践支撑)
DevOps 理念
打破开发(Dev)和运维(Ops)的壁垒
目标:快速、频繁、可靠地交付软件
CI 持续集成
开发者频繁提交代码,每次提交自动构建 + 测试
尽早发现问题
CD 持续交付/部署
自动将通过测试的代码部署到生产
实现"每天多次发布"
云原生与 DevOps 的关系
云原生(容器 + K8s)为 DevOps 提供了技术基础
DevOps 是云原生落地的实践方法
🎯 8.8 云原生解决了什么
解决了环境一致性问题(容器化)
解决了大规模容器管理问题(K8s 编排)
解决了配置漂移问题(不可变基础设施)
解决了变更效率问题(声明式 + 自动化)
解决了资源利用率问题(弹性伸缩)
✅ 8.9 云原生的价值总结
弹性:按需扩缩容,应对流量波动
效率:自动化部署、自愈,降低运维成本
一致性:容器 + 不可变,环境统一
敏捷:CI/CD + 声明式,快速交付
资源利用率:容器共享 + 弹性,降低成本
⚠️ 8.10 云原生的挑战
挑战1:学习和落地成本高
K8s 复杂,需要专业团队
挑战2:架构改造成本
传统应用要适配云原生,需要改造(如无状态化、配置外置)
挑战3:安全与合规
容器安全、镜像安全、多租户隔离
挑战4:监控和排障复杂度上升
需要完善的可观测性体系
🎯 8.11 架构师决策指南:云原生落地路径
落地的成熟度模型(循序渐进)
阶段1:容器化(把应用打包成容器)
阶段2:编排化(用 K8s 管理容器)
阶段3:服务化(微服务 + 服务治理)
阶段4:网格化(引入服务网格)
阶段5:Serverless 化(部分场景无服务器化)
架构师的忠告
云原生是"演进",不是"一步到位"
先容器化,再考虑更高级的能力
组织能力和技术能力要同步建设
🔭 九、可观测性与稳定性治理 —— 分布式架构的"眼睛"
📖 9.1 为什么可观测性在演进后期变得至关重要
单体时代:一个应用,日志集中,排障简单
微服务/云原生时代:一个请求跨几十个服务、几百个容器
没有可观测性 = 盲人摸象,无法排障、无法优化
可观测性是分布式架构的"必要配套",不是"可选项"
📊 9.2 可观测性三大支柱
指标(Metrics)
定义:可聚合的数值数据(如 QPS、延迟、错误率、CPU 使用率)
用途:监控大盘、告警、趋势分析
代表:Prometheus(采集)+ Grafana(可视化)
关键指标:RED 方法(Rate 请求率、Errors 错误率、Duration 延迟)
链路追踪(Tracing)
定义:追踪一个请求在多个服务间的完整调用链路
用途:定位跨服务的性能瓶颈和故障点
核心概念:Trace(一次完整请求)、Span(一次服务调用)
代表:Jaeger、Zipkin、SkyWalking、OpenTelemetry(标准)
解决的问题:"这个慢请求到底慢在哪个服务?"
日志(Logging)
定义:离散的事件记录
用途:记录详细的执行信息,用于审计和深度排障
代表:ELK(Elasticsearch + Logstash + Kibana)、Loki
挑战:海量日志的采集、存储、检索
三者的关系
指标:发现"有问题"(错误率上升)
链路:定位"哪里有问题"(哪个服务慢)
日志:分析"为什么有问题"(具体错误原因)
🛡️ 9.3 稳定性治理
混沌工程(Chaos Engineering)
思想:主动注入故障,验证系统的容错能力
例:主动杀掉一个服务实例,看系统能否自愈
代表:Netflix Chaos Monkey、ChaosBlade
原则:在可控范围内"以攻代守",提前发现隐患
容灾与高可用
多可用区部署:同城多机房,应对机房级故障
多地域部署:异地多活,应对地域级灾难
故障切换:自动/手动将流量切到健康节点
全链路压测
在生产环境模拟真实流量压力
发现系统的真实瓶颈
应急预案与演练
制定故障应急预案,定期演练
目标:故障发生时快速响应、快速恢复
🎯 9.4 架构师决策指南
可观测性建设要"前置"
不要等系统出问题才建监控,要在架构设计时就规划
"没有监控的服务,等于裸奔"
稳定性是"设计"出来的,不是"测"出来的
在架构层面考虑容错、降级、隔离
投入可观测性 = 投入未来的排障效率
🔮 十、架构演进的未来趋势
🚀 10.1 从"应用架构"到"平台工程(Platform Engineering)"
趋势:基础设施能力越来越"平台化、产品化"
开发者体验(Developer Experience)成为核心
内部开发者平台(IDP):让开发者自助式使用基础设施
目标:让业务开发者专注业务,平台团队提供"金色路径"
🤖 10.2 AI 驱动的软件工程
AI 辅助编码:代码生成、补全、审查
AIOps:用 AI 做智能监控、根因分析、自动运维
AI 对架构的影响
应用需要适配 AI(如提供 API 供 AI 调用)
AI 应用的架构特点(推理服务、模型管理、向量数据库)
架构师的新课题:如何设计"AI 友好"的系统
🔄 10.3 演进式架构(Evolutionary Architecture)
核心思想(《演进式架构》一书)
架构不是一次设计到位,而是"持续演进"
通过"适应度函数"(Fitness Function)持续评估架构是否健康
适应度函数
定义:衡量架构某些特性的指标(如性能、安全、可维护性)
例:每次构建自动检查"服务间依赖是否产生循环"
作用:让架构演进"可度量、可守护"
对架构师的启示
接受"架构会变化"的事实
设计时就为"未来的变化"留好扩展点
🧭 十一、架构师方法论 —— 如何做出正确的架构决策
🎯 11.1 架构选型的决策框架
第一步:明确业务现状与诉求
业务规模:用户量、订单量、增长趋势
团队规模:多少人协作
核心诉求:是求快、求稳、还是求省?
第二步:识别核心矛盾
是协作效率问题?(团队大 → 需要拆分)
是扩展性问题?(流量大 → 需要分布式)
是稳定性问题?(故障多 → 需要治理)
第三步:评估方案的收益与成本
收益:解决了什么问题,带来什么价值
成本:引入复杂度、运维成本、学习成本、迁移成本
关键问:收益是否显著大于成本?
第四步:选择"最适合"而非"最先进"
警惕技术跟风
适合当前阶段的才是最好的
第五步:小步验证,渐进演进
不要一步到位
先在局部试点,验证后再推广
📏 11.2 避免过度设计(架构师的大忌)
什么是过度设计
为"可能永远不会出现"的需求,提前引入复杂架构
例:3 人团队上来就搞微服务 + 服务网格 + Serverless
过度设计的代价
复杂度失控、交付变慢、维护成本高
如何避免
YAGNI 原则:你不会需要它(You Ain't Gonna Need It)
只为"确定的、当前的"需求设计
为"未来的变化"留扩展点,但不提前实现
架构师的自省
"我引入这个复杂度,是为了解决当前的真实问题,还是为了炫技?"
📐 11.3 演进式架构的实践
接受不完美
没有一劳永逸的架构
架构是"长"出来的,不是"设计"出来的
小步快跑
每次演进一小步,可控、可回滚
避免"大爆炸式"重构
持续重构
架构的腐化是必然的(技术债累积)
定期重构,偿还技术债
守护架构质量
用适应度函数、架构守护规则,防止架构腐化
⚖️ 11.4 架构权衡的常见维度(Trade-off)
一致性 vs 可用性(CAP)
性能 vs 可维护性
灵活性 vs 简单性
复用性 vs 耦合度
成本 vs 体验
架构师的核心能力:在权衡中找到当前最优解
🧠 11.5 架构师的成长心法
心法1:理解"为什么"比记住"是什么"更重要
每一代架构都有它诞生的背景和解决的问题
理解了背景,才能判断何时该用
心法2:架构服务于业务,而非技术服务于技术
永远先问:这为业务创造了什么价值?
心法3:没有银弹
每个方案都有适用场景和局限
警惕"一招鲜吃遍天"的思维
心法4:演进优于一步到位
接受变化,拥抱演进
在持续的重塑中保持生命力
心法5:技术选型要匹配团队能力
再好的技术,团队用不起来也是灾难
组织能力是架构落地的前提
收藏
立即使用
收藏
立即使用
收藏
立即使用
收藏
立即使用

Collect
Get Started

Collect
Get Started
Collect
Get Started
Collect
Get Started
评论
0 条评论
下一页

