
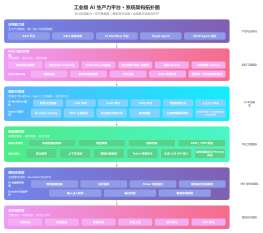
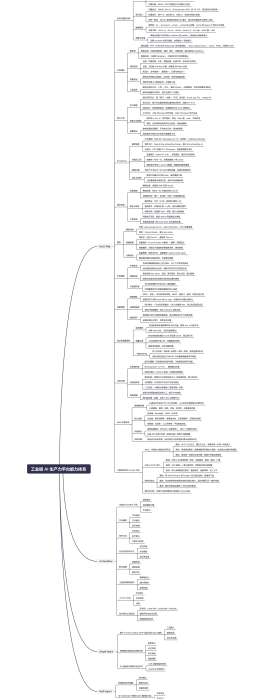
AI生产落地:工业级 AI 生产力平台能力体系
2026-10-19 20:24:51 0 举报帮助企业快速落地AI能力、提供从模型对接,知识处理,内嵌多种AI应用模板,开箱即用的AI工具,灵活的业务集成,可视化流程编排等能力,安全可靠的使用大模型服务,并可以在多云环境下灵活选择算力和模型, 低成本高质量,低门槛的的利用的AI能力,实现业务+AI的应用,提升企业竞争力
AI
Agent
Workflow
Prompt
工业级
模板推荐
作者其他创作
大纲/内容
RAG 平台
私有向量知识库
存储选型
向量库:Milvus 2.4 集群版 / Qdrant / pgvector,按 QPS 与数据量选型
落地:日 QPS < 50、数据量 < 1000 万向量用 pgvector 单实例即可,与业务库同源省运维
落地:QPS 50~500 或亿级向量上 Milvus 2.4 集群版,按租户分 collection,检索节点与索引节点分离部署
落地:Qdrant 适合中等规模且需强过滤场景,单机 8C32G 可承载千万级向量,先压测再定副本数
元数据库:MySQL 存文档、Chunk、版本、权限关系
落地:MySQL 8.0 主从部署,kb/document/chunk/version/acl 五张核心表按 doc_id 分片,读写分离
落地:大字段(原文、解析中间态)不入 MySQL,只存对象存储地址,避免单表膨胀
落地:所有表带 tenant_id 前缀索引,删除走软删除标记,保留 30 天可回滚
对象存储:MinIO / OSS 存原始文件与解析中间件
落地:MinIO 集群至少 4 节点纠删码模式,桶按租户划分,原始文件与解析中间件分桶存储
落地:文件路径规则 tenant/kb/doc_id/version/original.pdf,版本号变更即写新对象,不覆盖旧文件
落地:配置生命周期策略,中间态文件保留 7 天自动清理,原始文件永久保留并做跨机房同步
索引设计
向量索引:HNSW(M=16,efConstruction=200)或 IVF_PQ,按召回与内存权衡
落地:数据量 < 500 万且内存充足选 HNSW,M 取 16、efConstruction 取 200,查询 ef 取 64~128
落地:数据量过亿或内存受限选 IVF_PQ,nlist 取 sqrt(N)*4,nprobe 调至召回率达 0.95 为止
落地:上线前用真实 query 集跑召回率-延迟曲线,固化参数到配置中心,改参需走灰度
标量索引:租户 ID、知识库 ID、文档 ID、生效时间做分区键
落地:向量库侧把 tenant_id、kb_id 设为 partition key,查询必带这两个条件做前置过滤
落地:MySQL 侧对 tenant_id + doc_id、tenant_id + effective_time 建联合索引,支撑元数据查询
落地:过滤条件在 SDK 层统一封装,禁止业务代码绕过直接查全库
双写一致性:MySQL 事务提交后发 MQ 事件,异步写向量库并记录写入状态
落地:业务事务内写 MySQL 并投递 MQ(RocketMQ 事务消息),消费者异步写向量库
落地:写入状态表记录 chunk_id + 状态 + 重试次数,失败进死信队列并告警
落地:每日对账任务抽样比对 MySQL chunk 数与向量库 count,差异超阈值触发全量修复
数据模型
表结构:kb → document → chunk → embedding 四级,chunk 存 parent_id 支持父子检索
落地:kb 表存知识库元信息,document 表存文件与版本,chunk 表存切片与 parent_id,embedding 表存向量引用
落地:父子检索时先召回子块,再按 parent_id 取父块全文送模型,兼顾精度与上下文完整
落地:chunk 表按 tenant_id + doc_id 建联合索引,单文档 chunk 数超 10 万时拆表
必备字段:chunk_id、doc_id、version、tenant_id、acl_tags、token 数、hash
落地:chunk_id 用雪花 ID,hash 用内容 SHA256 用于去重与增量比对
落地:acl_tags 存 JSON 数组并建倒排索引,token 数字段用于上下文预算裁剪
落地:version 与 doc_id 组合唯一约束,保证同文档同版本不重复入库
容量与运维
单集合按租户/知识库分 collection 或 partition,避免超大规模单索引
落地:租户数 < 100 时每租户独立 collection,租户多时改为单 collection + partition by kb_id
落地:单 collection 向量数控制在 5000 万以内,超限按业务线再拆库
落地:collection 命名规则 kb_{tenant}_{kb_id},由元数据服务统一管理映射关系
定期 compact 与索引重建,快照备份 + 异地容灾
落地:每周低峰期执行 compact,索引重建走影子 collection 双写切换,避免停服
落地:每日全量快照 + 每小时增量备份,快照存异地对象存储,保留 7 天
落地:每季度做一次容灾演练,验证从快照恢复到可服务状态在 2 小时内完成
文档清洗
解析层
格式适配:PDF(PyMuPDF/pdfplumber 双引擎兜底)、Word(python-docx)、Excel、HTML、扫描件 OCR
落地:PDF 先走 pdfplumber 保留版面,失败或乱码率高时自动切 PyMuPDF 重试一次
落地:Word/Excel/HTML 各用专用解析器,扫描件走 OCR(PaddleOCR),OCR 置信度低于 0.8 的页标记待复核
落地:解析器统一封装为 Parser 接口,按 MIME 类型路由,新增格式只加实现不改主流程
版面还原:识别标题层级、表格、图片、页眉页脚,输出结构化 Markdown
落地:按字体大小与加粗识别标题层级,输出 Markdown 的 #/##/### 结构
落地:表格转 HTML 再转 Markdown,图片提取到对象存储并在原位留占位标记
落地:页眉页脚按页面位置与重复度识别后剔除,保留正文页码映射供溯源使用
表格处理:小表转 Markdown,大表按行切片并保留表头
落地:列数 ≤ 8 且行数 ≤ 50 的表格整体转 Markdown 作为一个块
落地:大表按行切片,每片都重复表头,并在块首注明「表名 + 第 N 行起」
落地:合并单元格先展开为笛卡尔填充,避免切片后语义丢失
清洗规则
去噪:页眉页脚、水印、重复段落、乱码字符、多余空白与换行
落地:用正则 + 位置规则剔除页眉页脚、水印文本、连续重复段落与乱码字符
落地:多余空白与换行统一收敛为单个换行,保留段落边界
落地:清洗规则配置化,可按知识库开启或关闭,规则命中数量记入日志便于调优
去重:文档级 SimHash 去重,段落级 MinHash 去重
落地:文档级用 SimHash 64 位,汉明距离 ≤ 3 判为重复,重复文档直接跳过入库
落地:段落级用 MinHash + LSH 分桶,相似度 ≥ 0.9 的段落只保留首个
落地:去重结果写入 dup_of 字段,保留溯源链路,便于人工复核误杀
规范化:全半角统一、繁简统一、日期与单位归一
落地:全半角、繁简、大小写统一在清洗阶段一次性完成,写入前做最终校验
落地:日期统一为 YYYY-MM-DD,金额与单位统一为数值 + 标准单位
落地:归一化规则表可配置,新增业务单位只加映射不改代码
质量校验
解析后字符数与页数比、乱码率、空块率阈值告警
落地:字符数/页数比低于 200 判为疑似扫描件解析失败,乱码率 > 5%、空块率 > 10% 触发告警
落地:指标按文档维度写入质量表,接入看板按知识库聚合展示
落地:阈值可按知识库配置,告警推送至负责人的企微群
低质文档进人工复核队列,不直接入库
落地:低质文档进入人工复核队列,复核界面并排展示原文与解析结果
落地:复核结论(通过/修正/拒绝)回流为标注数据,用于迭代解析规则
落地:未复核文档状态置为 pending,检索时默认不召回
工程实现
解析任务异步化:上传 → MQ → 解析 Worker → 结果落库,支持失败重试与断点
落地:上传接口只做落库与投递 MQ,解析由独立 Worker 集群消费,按文档 ID 做幂等
落地:任务表记录状态与重试次数,失败按指数退避重试 3 次后进死信队列
落地:Worker 无状态部署,可水平扩容,大文件走单独队列避免阻塞小文件
解析结果留存中间态,便于回溯与二次清洗
落地:解析中间态(结构化 JSON、图片地址、页级文本)存对象存储,路径带 doc_id + version
落地:二次清洗直接读中间态,无需重新解析原文件,节省算力
落地:中间态保留 30 天,超期归档,支持按 doc_id 回溯任意历史版本
语义分块
切分策略
递归字符切分:按「章节 → 段落 → 句子」优先级,chunk_size 512、overlap 64
落地:按分隔符优先级 [章节标题, 段落, 句号, 逗号] 递归切分,直至块长落入 512 token 内
落地:overlap 取 64 token,在句边界处回退,避免切断句子
落地:切分器封装为策略类,参数由知识库配置,支持按文档类型切换
语义切分:基于句向量相邻相似度突变点断句,阈值 0.6~0.75
落地:对句子做向量化,计算相邻句余弦相似度,低于阈值处断块
落地:阈值按语料调优,默认 0.7,长文档先降采样再计算以控制耗时
落地:语义切分与递归切分结果做抽样对比,命中率更高者作为该库默认策略
结构切分:按标题层级切,标题路径作为 chunk 前缀注入
落地:按 Markdown 标题层级切块,H3 以下合并,保证单块不过短
落地:每块前缀注入「文档名 > 一级标题 > 二级标题」路径,提升检索语义匹配
落地:标题路径同时写入元数据,供引用溯源展示层级位置
父子切分:子块 256 token 用于检索,父块 1024 token 用于生成
落地:子块 256 token 入向量库用于检索,父块 1024 token 存 MySQL 用于生成
落地:chunk 表 parent_id 指向父块,检索命中子块后按 parent_id 取父块全文
落地:父子比例按业务调优,问答型知识库可放大父块到 2048 token
参数与元数据
每块写入 doc_id、章节路径、页码、token 数、hash、生效时间
落地:每块写入 doc_id、章节路径、页码、token 数、hash、生效时间,字段固定不可缺
落地:元数据随向量一起写入,检索时可直接返回无需回表
落地:生效时间支持未来生效,检索时按当前时间过滤,实现知识时效控制
表格、代码块单独成块并标记类型,避免被截断
落地:表格与代码块单独成块并标记 chunk_type=table/code,不参与普通切分
落地:代码块按函数或类边界切分,保留语言标记,避免语法断裂
落地:表格块保留表头,超长时按行切分并重复表头
质量验证
抽样检查块完整率、平均块长分布、跨块断裂率
落地:每批随机抽 100 块人工检查完整性,块完整率低于 95% 需调整切分参数
落地:统计平均块长与长度分布,出现双峰分布说明策略混用需拆分
落地:跨块断裂率通过句子是否被切断统计,超过 5% 需增大 overlap
用检索命中率对比不同切分策略做 A/B
落地:固定 100 条评测 query,对比不同切分策略的 Recall@5 与 MRR
落地:A/B 结果写入评测报告,选定策略后固化到知识库配置
落地:换策略时保留旧索引一段时间,支持灰度与快速回滚
Embedding
模型选型
中文通用:BGE-M3 / bge-large-zh-v1.5;多语言:multilingual-e5-large
落地:中文知识库默认 BGE-M3(1024 维),兼顾稠密与稀疏输出,一套模型两种检索
落地:多语言场景用 multilingual-e5-large,查询与文档需加不同前缀
落地:模型选定后写入知识库配置,禁止同库混用不同模型
商用 API:OpenAI text-embedding-3-large、通义 text-embedding-v3
落地:数据合规允许出境时用 text-embedding-3-large(3072 维),需评估单次批量成本
落地:国内业务优先通义 text-embedding-v3,延迟与合规更可控
落地:商用 API 必须配置降级到本地模型的兜底路径,避免供应商故障导致入库中断
私有化:GPU 部署 TEI / Xinference,批量推理提升吞吐
落地:TEI 部署在 GPU 节点,开启 dynamic batching,单卡 A10 可达 500 QPS 以上
落地:Xinference 适合多模型共存场景,按模型分配显存配额
落地:私有化部署需做压测确定 batch 与并发上限,写入配置中心供 Worker 读取
向量化工程
批量提交(batch 64~128)、失败重试、限流与并发控制
落地:批量提交 batch 取 64~128,按 GPU 显存与接口限流动态调整
落地:失败按指数退避重试 3 次,仍失败则记录并跳过,由补偿任务兜底
落地:全局限流用令牌桶控制 QPS,避免打满模型服务影响在线检索
维度统一与归一化,距离度量统一用 cosine
落地:入库前统一 L2 归一化,距离度量统一用 cosine,避免不同模型行为差异
落地:维度写入 collection schema,变更维度必须新建 collection 而非就地改
落地:归一化与度量方式封装在 Embedding 客户端,业务层不可绕过
模型版本号写入 chunk 元数据,换模型时整库重建
落地:chunk 元数据记录 embedding_model 与 model_version
落地:换模型时新建 collection 全量重建,双写一段时间后切流量
落地:旧 collection 保留 7 天用于回滚,确认稳定后删除
稀疏向量
同步产出 BM25 / SPLADE 稀疏向量,供混合检索使用
落地:入库时同步产出 BM25 稀疏向量写 ES,SPLADE 用于语义稀疏召回
落地:稀疏向量与稠密向量共用 chunk_id,保证两路召回可对齐融合
落地:BM25 分词器按领域配置词典,专业术语加入自定义词表
成本与性能
缓存已向量化文本的 hash,避免重复计算
落地:以文本 SHA256 为 key 缓存向量结果,命中直接复用,避免重复推理
落地:缓存存 Redis,TTL 30 天,容量按热点文档规模设定
落地:缓存命中率纳入监控,低于 30% 说明重复率低可考虑关闭
大批量重建走离线任务,避开在线流量高峰
落地:全量重建走离线任务队列,限速至在线流量的 30% 以内
落地:重建任务安排在凌晨低峰,按知识库分批执行,每批完成后校验数量
落地:重建期间新旧索引并存,通过别名切换实现无缝上线
混合检索
检索通道
稠密检索:向量库 ANN 召回 Top 50
落地:查询向量在向量库 ANN 召回 Top 50,ef 参数按召回率调优
落地:召回结果带 chunk_id 与分数,供后续融合使用
落地:单路超时设 300ms,超时则该路返回空并记录降级日志
稀疏检索:BM25 / ES 关键词召回 Top 50
落地:ES 建 BM25 索引,字段含标题、正文、章节路径,标题权重设为 2
落地:召回 Top 50,使用 match + 短语匹配组合提升精确度
落地:ES 索引与向量库同步更新,由同一 MQ 事件驱动保证一致
元数据过滤:租户、知识库、时间、标签前置过滤
落地:租户、知识库、时间、标签等过滤条件在检索请求中前置下推
落地:向量库侧用 partition + filter 表达式,ES 侧用 filter 子句,均不走后过滤
落地:过滤条件由权限服务统一生成,业务代码不可自行拼装
融合与调优
融合算法:RRF(k=60)或加权分数归一化
落地:默认用 RRF,k 取 60,按排名而非分数融合,避免量纲差异
落地:需精细调权时改用加权分数归一化,权重从配置中心读取
落地:融合结果保留两路原始排名,便于排查召回偏差
查询改写:多查询扩展、HyDE、指代消解后重写
落地:多查询扩展用 LLM 生成 2~3 个同义改写,并行检索后融合
落地:HyDE 先生成假设答案再检索,适合短查询与专业术语场景
落地:多轮会话先做指代消解与省略补全,再进入检索
参数可配:各通道 TopK、权重、最小分数阈值
落地:各通道 TopK、权重、最小分数阈值全部配置化,按知识库维度覆盖
落地:参数变更走灰度,先对 5% 流量生效并对比命中率
落地:参数版本与评测结果绑定,可一键回滚到上一组参数
工程实现
两路并行召回,超时 300ms 兜底降级为单路
落地:稠密与稀疏两路用线程池并行发起,总超时 300ms
落地:任一路超时或报错时降级为单路结果,不阻塞整体响应
落地:降级次数纳入监控,持续降级需排查对应通道健康度
检索结果去重(按 chunk hash 与内容相似度)
落地:按 chunk hash 精确去重,再按内容相似度 > 0.95 做近似去重
落地:同一文档多个块命中时限制单文档最多占 3 个名额,提升结果多样性
落地:去重后重新编号,保证与后续引用角标一致
重排
模型选型
开源:bge-reranker-v2-m3、Qwen3-Reranker,GPU 批量推理
落地:bge-reranker-v2-m3 部署在 GPU,单卡批量 32 条,P99 延迟控制在 200ms 内
落地:Qwen3-Reranker 适合中文长文本,需按 max_length 截断避免显存溢出
落地:模型加载常驻显存,避免每次请求冷启动
商用:Cohere Rerank、通义 gte-rerank
落地:Cohere Rerank 适合多语言,注意单次请求文档数上限与调用成本
落地:通义 gte-rerank 国内延迟低,作为主选,Cohere 作为备份
落地:商用 API 需配置超时与降级到本地模型的路径
策略配置
两阶段:召回 Top 50 → 重排取 Top 5~8
落地:召回阶段取 Top 50,重排后取 Top 5~8 送入生成,控制上下文长度
落地:Top N 按模型上下文窗口反推,预留系统提示与历史对话 token
落地:重排分数低于阈值的条目直接丢弃,宁少不凑
轻量粗排(Cross-Encoder 小模型)+ 精排,控制延迟
落地:粗排用小 Cross-Encoder(如 bge-reranker-base)快速筛到 Top 20
落地:精排用大模型对 Top 20 重排取 Top 5,兼顾效果与延迟
落地:粗排与精排阈值分别配置,可按场景关闭精排走快路径
阈值截断:分数低于阈值的结果直接丢弃,避免凑数
落地:设定绝对分数阈值与相对阈值(不低于最高分的 60%)
落地:截断后结果少于 2 条时提示「资料不足」而非强行生成
落地:阈值通过离线评测集调优,取准确率与召回率的平衡点
性能优化
批量推理、请求内并行、结果缓存(query+chunk hash)
落地:单请求内对候选块批量推理,一次前向完成 32 条打分
落地:结果按 query hash + chunk hash 缓存,TTL 1 小时
落地:热点 query 走本地缓存,命中率纳入监控
重排超时降级为原始排序,不阻塞主链路
落地:重排服务超时设 300ms,超时直接返回原始召回顺序
落地:降级时在响应中标记 rerank_degraded,便于问题追踪
落地:连续降级触发告警,自动摘除异常实例
引用溯源
引用生成
生成时强制模型输出 [1][2] 角标,与上下文块序号绑定
落地:系统提示词中约定引用格式为 [序号],并把上下文块按序号编号注入
落地:生成完成后用正则提取角标,与上下文序号做合法性比对
落地:输出流式渲染时先缓存全文,校验后再推送引用卡片
后处理校验角标合法性,剔除不存在或不支持的引用
落地:剔除不存在的序号、超出上下文范围的引用
落地:对引用句做语义校验,句与块相似度低于 0.6 的引用标记为弱引用
落地:校验失败的引用降级为纯文本,不展示角标
溯源信息
每块返回 doc_name、页码、章节路径、原文片段、原文链接
落地:检索返回时带上 doc_name、page_no、section_path、snippet、file_url
落地:snippet 截取命中位置前后各 100 字,命中词高亮
落地:file_url 用带时效签名的链接,防止越权访问原文件
前端点击角标定位到原文档对应位置并高亮
落地:前端按 doc_id + page_no + 坐标定位 PDF 并高亮命中区域
落地:非 PDF 文档跳转到原文对应章节锚点
落地:点击埋点回流,统计引用点击率作为答案可信度参考
可信度控制
无引用支撑的句子标记为「模型推断」
落地:无引用支撑的句子在渲染层加灰色标记与「模型推断」提示
落地:整段均无引用时在答案末尾统一提示,不逐句打扰
落地:标记比例纳入质量看板,超过 20% 触发提示词优化
引用覆盖率作为答案质量指标纳入监控
落地:引用覆盖率 = 有引用句数 / 总句数,按天按知识库聚合
落地:覆盖率低于 70% 告警,定位到检索召回或提示词约束问题
落地:指标与人工采纳率做相关性分析,验证指标有效性
权限隔离
权限模型
RBAC:角色 → 知识库读写权限;ABAC:按部门、密级、项目标签过滤
落地:RBAC 管理知识库级读写权限,角色与组织架构同步
落地:ABAC 按部门、密级、项目标签动态计算可访问范围
落地:两种模型结果取交集,权限服务统一输出可访问标签集合
权限标签下沉到 chunk 级 acl_tags,检索时作为硬过滤条件
落地:入库时把文档权限继承到 chunk,写入 acl_tags 数组
落地:权限变更触发该文档 chunk 的 acl_tags 批量更新任务
落地:acl_tags 建倒排索引,检索时作为硬过滤条件
检索期隔离
用户身份 → 可访问标签集合 → 拼入向量库 filter,禁止先召回后过滤
落地:请求进来先查用户可访问标签集合,拼成 filter 表达式下推到向量库
落地:禁止先全量召回再内存过滤,避免越权与性能问题
落地:filter 表达式由权限服务生成并签名,防止被篡改
多租户物理隔离:独立 collection 或独立库
落地:高密级租户使用独立 collection 或独立向量库实例,物理隔离
落地:普通租户共享实例但按 partition 隔离,配额独立
落地:隔离级别写入租户配置,开通时自动创建对应资源
越权防护
系统提示词与工具层双重校验,禁止模型自行扩大检索范围
落地:系统提示词明确限定检索范围,工具层再次校验知识库 ID 白名单
落地:模型请求的检索参数经服务端重写,忽略模型给出的越权范围
落地:越权尝试记录安全日志并告警
全量检索日志审计,异常访问告警
落地:检索日志记录用户、知识库、filter 条件、返回条数与耗时
落地:异常模式(高频跨库查询、超大 TopK)实时告警
落地:日志保留 180 天,支持按用户追溯访问轨迹
知识库增量更新
变更捕获
文档新增/修改/删除事件经 MQ 投递,携带 doc_id 与版本号
落地:文档服务在增删改后投递 MQ 事件,消息体含 doc_id、version、操作类型
落地:消费端按 doc_id 做幂等,重复消息直接丢弃
落地:事件失败进入重试队列,超限告警人工介入
内容 hash 比对,无变化直接跳过
落地:入库前计算文档内容 SHA256,与库中最新版本比对
落地:hash 相同直接跳过,仅更新 updated_at
落地:hash 不同但差异小于 5% 时走章节级 diff,减少重建量
增量处理
按文档粒度先删旧 chunk 再写新 chunk,保证原子性
落地:以 doc_id + version 为事务边界,先标记旧 chunk 失效,再写入新 chunk
落地:写入完成后统一更新文档版本号,保证检索侧看到一致视图
落地:删除旧 chunk 走异步任务,避免长事务锁表
大文档按章节级 diff,只重建变化章节
落地:按章节 hash 比对,只对变化章节重新切分与向量化
落地:未变化章节的 chunk 直接复用,仅更新 doc_version
落地:章节级 diff 结果记录日志,便于核对重建范围
删除走软删除 + 异步清理向量
落地:删除先置 is_deleted=1 并从检索过滤条件中排除
落地:异步任务在 24 小时内清理向量库与 ES 中对应数据
落地:清理失败进入补偿队列,每日对账兜底
一致性与补偿
写入状态机:待处理 / 处理中 / 成功 / 失败,失败进重试队列
落地:状态机四态流转,每次变更写状态表并记录时间戳
落地:失败任务进重试队列,按指数退避重试 3 次
落地:状态表按天分区,历史数据归档
定时对账任务比对 MySQL 与向量库数量差异并修复
落地:每日凌晨跑对账任务,按 doc_id 比对 MySQL chunk 数与向量库 count
落地:差异超过 1% 触发修复任务,按 doc_id 全量重建
落地:对账报告推送负责人,连续异常升级处理
幻觉治理
生成侧约束
提示词强制「仅依据给定资料回答,无依据则说明不知道」
落地:系统提示词固定三段结构:角色约束、仅依据资料回答、无依据明确说明不知道
落地:把「不知道」作为合法输出,避免模型为满足指令而编造
落地:提示词版本化管理,改动需过评测集回归
低 temperature(0~0.3),限制输出长度
落地:temperature 设 0.1,top_p 设 0.8,事实型问答禁用高随机性
落地:max_tokens 按场景限制,避免模型发散补全
落地:不同场景(问答/摘要/改写)配不同参数模板
结构化输出 + Schema 校验,字段缺失即重试
落地:用 JSON Schema 约束输出结构,字段缺失或类型错误自动重试一次
落地:重试仍失败则降级为纯文本输出并提示
落地:Schema 随业务字段演进,需保持向后兼容
校验侧兜底
事实校验:答案句子与召回块做 NLI / 相似度校验,低分句标注
落地:用 NLI 模型判断答案句是否被召回块蕴含,分数低于 0.6 标记为存疑
落地:无 NLI 资源时用向量相似度替代,阈值相应调高
落地:存疑句在渲染层加提示,不直接删除以免破坏可读性
引用强制:无引用句不允许作为结论输出
落地:结论性语句必须带引用角标,无引用则不允许作为结论输出
落地:校验在流式输出前完成,避免前端展示后撤回
落地:引用缺失率纳入质量指标
二次自检:小模型对答案做「是否有据」判别
落地:用小模型(如 Qwen 7B)对答案做「是否有据」二分类判别
落地:判别结果与 NLI 分数加权,双低才判定为幻觉
落地:判别样本回流用于优化提示词
兜底策略
检索为空或置信度低时转人工 / 提示补充信息
落地:检索结果为空或最高分低于阈值时,直接提示「知识库中未找到相关内容」
落地:提供补充信息引导与转人工入口
落地:低置信度问题记录,用于补充知识库
高风险场景(金额、法务)加人工复核节点
落地:金额、法务、合同类问题强制走人工复核节点
落地:复核界面展示答案、引用原文与置信度,支持一键修正
落地:复核结论回流为标注数据
RAG 评测体系
数据集构建
从真实日志采样 200~500 条问题,人工标注标准答案与正确文档
落地:从线上日志按频次与业务价值分层采样 200~500 条真实问题
落地:每条标注标准答案、正确文档与正确 chunk
落地:标注规范文档化,双人标注分歧由第三人仲裁
分层覆盖:单跳、多跳、否定、时效性、无答案类问题
落地:单跳问题占 50%,多跳 20%,否定与时效性各 10%,无答案 10%
落地:每类问题不少于 30 条,保证统计显著性
落地:新业务上线前补充对应领域问题集
核心指标
检索侧:Recall@K、MRR、命中率
落地:Recall@5、Recall@10、MRR 离线批量计算,目标 Recall@10 ≥ 0.9
落地:命中率按 query 维度统计,未命中样本逐条分析
落地:检索指标只评检索环节,与生成指标解耦
生成侧:事实准确率、答案相关性、引用准确率、无答案识别率
落地:事实准确率用人工或 LLM 裁判评分,抽样 100 条
落地:引用准确率 = 引用正确句数 / 有引用句数
落地:无答案识别率单独统计,避免被平均分掩盖
端到端:幻觉率、人工采纳率、平均响应时延
落地:幻觉率 = 无据句数 / 总句数,端到端核心指标
落地:人工采纳率来自线上点赞与纠错数据
落地:平均响应时延按 P50/P95 分位统计,兼顾体验
评测执行
离线批量跑分(RAGAS / 自研脚本),接入 CI 做版本回归
落地:用 RAGAS 或自研脚本批量跑分,输出结构化报告
落地:接入 CI,每次提示词或检索参数变更自动回归
落地:指标劣化超过 3% 阻断发布
在线 A/B 与用户反馈(点赞/纠错)回流扩充数据集
落地:线上按用户 ID 分桶做 A/B,对比采纳率与幻觉率
落地:点赞、纠错、无答案反馈回流为新增评测样本
落地:每周更新一次评测集,保持与真实分布一致
闭环机制
指标劣化自动告警,定位到切分/检索/重排/提示词具体环节
落地:指标按天计算,环比劣化超阈值自动告警
落地:告警附带分解指标,快速定位到切分、检索、重排或提示词环节
落地:定位结论沉淀为排查手册,缩短后续响应时间
大模型应用与 Prompt 工程
AIGC、多模态大模型应用开发
落地:AIGC 以文生文、图生文为主,多模态统一走同一网关接入
落地:按场景选模型,图像理解用多模态大模型,生成用文生图专用模型
落地:输出统一封装为业务对象,屏蔽不同供应商差异
主流 LLM API 接入
落地:所有 LLM 调用经统一网关,封装鉴权、重试、超时、计费
落地:SDK 层统一入参出参结构,切换供应商只改配置
落地:接入前做兼容性测试,覆盖流式、函数调用、长上下文
结构化输出
落地:用 JSON Schema 或 Pydantic 定义输出结构,随请求下发
落地:优先使用供应商原生结构化输出能力,其次用提示词 + 解析兜底
落地:解析失败自动重试一次并记录失败率
提示词工程:可基于业务场景设计系统级 Prompt 体系
落地:Prompt 分系统级、场景级、用户级三层,系统级统一维护
落地:模板变量化,支持变量插值与默认值,禁止硬编码业务文本
落地:Prompt 版本化管理,改动过评测集回归后发布
AI Workflow
可视化 Workflow 平台
前端画布
基于 React Flow / X6 实现节点拖拽、连线、缩放、小地图
落地:用 React Flow 实现画布,节点与连线数据由后端 JSON Schema 驱动
落地:支持拖拽、缩放、小地图、框选、对齐辅助线
落地:大流程(> 200 节点)开启虚拟渲染,避免卡顿
节点配置面板:入参、出参、模型、超时、重试、异常分支
落地:右侧配置面板按节点类型动态渲染表单,字段与后端 Schema 一致
落地:入参出参支持可视化映射,超时与重试给默认值
落地:表单校验前置,保存前拦截非法配置
画布 JSON Schema 化,支持导入导出与版本对比
落地:画布 JSON 定义版本号,导入时做兼容性校验
落地:支持导出为 JSON 与图片,版本对比高亮差异节点
落地:Schema 变更需保持向后兼容,破坏性变更升主版本
后端编排引擎
DAG 解析与拓扑排序,校验环路与孤立节点
落地:流程定义解析为 DAG,拓扑排序确定执行顺序
落地:保存时校验环路与孤立节点,不合法直接拒绝发布
落地:DAG 编译结果缓存,避免每次执行重复解析
执行器按节点类型分发,统一上下文对象传递变量
落地:执行器按节点类型注册处理器,统一上下文对象传递变量
落地:上下文不可变更新,节点输出写入新版本快照
落地:新增节点类型只加处理器,不改调度主流程
引擎选型:自研轻量引擎或 LangGraph / SpringAI 承载
落地:流程简单、需深度定制时选自研轻量引擎,可控性最高
落地:需要生态与图能力时选 LangGraph,Java 技术栈选 SpringAI
落地:引擎封装在统一接口后,避免业务代码绑定具体框架
平台能力
草稿 / 发布双态,发布生成不可变版本号
落地:草稿态可自由编辑,发布生成不可变版本号(v1、v2…)
落地:运行中的实例绑定发布版本,不受后续编辑影响
落地:支持版本回滚,回滚即切换当前生效版本
调试模式:单节点试跑、断点调试、变量快照查看
落地:单节点试跑可指定模拟入参,直接查看该节点输出
落地:断点调试在节点前后暂停,查看变量快照
落地:调试流量与生产隔离,不写业务数据
节点编排
节点类型
LLM 节点:模型、系统提示词、变量插值、输出 Schema
落地:LLM 节点配置模型、温度、系统提示词、变量插值与输出 Schema
落地:提示词中变量用 ${} 语法,运行时替换为上游节点输出
落地:输出 Schema 校验失败自动重试一次
Code 节点:Python / JS 沙箱(gVisor 或独立容器),超时与内存限额
落地:Code 节点运行在 gVisor 或独立容器沙箱,禁网、限 CPU 与内存
落地:默认超时 30s,内存上限 512MB,超限强制终止
落地:支持 Python 与 JS 两套运行时,依赖预装镜像
HTTP 节点:方法、URL、鉴权、超时、重试、响应映射
落地:HTTP 节点配置方法、URL、Header、鉴权、超时与重试
落地:响应支持 JSONPath 映射到输出变量
落地:出网需走白名单代理,禁止访问内网敏感地址
意图识别节点:分类模型或 LLM 分类,输出分支标签
落地:意图识别节点用分类模型或 LLM 分类,输出分支标签与置信度
落地:置信度低于阈值走兜底分支
落地:分类标签与分支条件一一对应,保存时校验完整性
节点契约
统一入参出参 Schema(JSON Schema 校验)
落地:每个节点定义输入输出 JSON Schema,运行时强校验
落地:Schema 作为节点契约写入注册中心,编排时据此校验连线
落地:Schema 变更需升版本,旧流程继续使用旧版本
变量引用语法 ${node_id.output.field},编译期做引用校验
落地:变量引用语法 ${node_id.output.field},编译期解析依赖图
落地:引用不存在或类型不匹配时保存即报错
落地:运行时缺失变量按默认值或空值处理并告警
执行控制
并发节点并行执行,串行节点顺序执行
落地:无依赖的节点并发执行,用线程池或协程调度
落地:有依赖的节点按拓扑序串行,汇合节点等待全部上游完成
落地:并发度上限可配置,避免打满下游服务
单节点超时、重试次数、失败策略(中断 / 跳过 / 走异常分支)
落地:单节点超时、重试次数、失败策略在节点级配置
落地:失败策略支持中断流程、跳过继续、走异常分支三种
落地:重试仅对幂等节点开放,非幂等节点默认不重试
条件分支
分支定义
条件表达式:布尔表达式 / 规则引擎(Aviator、Drools)
落地:简单条件用布尔表达式,复杂规则用 Aviator 或 Drools 规则引擎
落地:表达式在沙箱中求值,禁止执行任意代码
落地:表达式变量白名单校验,防止越权读取上下文
多路分支:switch-case + default 兜底分支
落地:多路分支用 switch-case 结构,必须有 default 兜底
落地:保存时校验 default 分支存在,否则拒绝发布
落地:分支标签与下游节点绑定,删除节点时提示联动
模型路由分支:按意图分类结果或置信度分流
落地:按意图分类结果直接路由到对应子流程
落地:置信度低于阈值时路由到澄清或人工分支
落地:路由规则可配置,支持按业务灰度调整
执行语义
只执行命中分支,未命中走 default,禁止无出口
落地:运行时只执行命中分支,其余分支跳过不计算
落地:未命中任何条件时走 default,禁止流程无出口
落地:分支执行结果记入 trace,便于回放排查
分支内变量作用域隔离,汇合节点做变量合并
落地:分支内变量作用域隔离,同名变量不互相污染
落地:汇合节点显式声明变量合并规则(覆盖/合并/取首个)
落地:合并冲突时以显式规则为准并记录日志
可视化与校验
分支连线标注条件,保存时校验条件互斥性与完整性
落地:分支连线标注条件表达式,画布上直接可见
落地:保存时校验条件互斥性与完整性,重叠或遗漏即报错
落地:校验结果以清单形式展示,支持一键定位问题分支
支持条件单测,构造输入验证走向
落地:支持构造输入对单个分支做单测,验证走向是否符合预期
落地:单测用例随流程版本保存,发布前自动跑
落地:失败用例给出实际走向与期望走向对比
长任务状态持久化
状态存储
每次节点执行后持久化执行快照:流程 ID、实例 ID、当前节点、上下文变量、时间戳
落地:每次节点执行后写一条快照记录,含流程 ID、实例 ID、当前节点、变量、时间戳
落地:快照写入异步化,不阻塞节点执行
落地:快照按实例 ID 分区存储,便于按实例回放
存储选型:MySQL 存元数据 + Redis 存热状态 + 对象存储存大变量
落地:MySQL 存实例与节点元数据,Redis 存热状态(TTL 7 天)
落地:大变量(> 64KB)存对象存储,快照中只存地址
落地:Redis 丢失可从 MySQL 快照重建,保证不丢状态
状态模型
实例状态机:运行中 / 挂起 / 成功 / 失败 / 已取消
落地:实例状态机五态流转,非法流转直接拒绝
落地:状态变更写事件日志,支持按状态查询实例
落地:挂起态设超时时间,超时自动转失败并告警
上下文变量做版本号,避免并发覆盖
落地:上下文变量带版本号,写入时做 CAS 校验
落地:并发更新冲突时后写者失败并重试
落地:版本号随快照持久化,恢复时校验一致
长任务支撑
异步节点(人工审批、外部回调)挂起后释放线程,由事件唤醒
落地:异步节点挂起后释放线程,仅保留状态记录
落地:由回调事件或定时任务唤醒,重新加载快照继续执行
落地:挂起实例数纳入监控,异常增长需排查
定时扫描超时实例,按策略重试或告警
落地:定时任务每分钟扫描超时实例,按策略重试或标记失败
落地:连续超时的流程触发告警并暂停调度
落地:扫描任务本身做幂等,避免重复处理同一实例
断点续跑
恢复机制
从最近一次成功节点的快照恢复,跳过已完成节点
落地:从最近一次成功节点的快照恢复,跳过已完成节点
落地:恢复前校验流程版本,版本不一致按兼容策略处理或拒绝
落地:恢复动作记审计日志,包含恢复人、时间、起始节点
恢复前校验流程版本,版本不一致走兼容或拒绝恢复
落地:流程版本号随实例保存,恢复时比对当前发布版本
落地:小版本差异允许兼容恢复,结构变更则拒绝并提示新建实例
落地:兼容规则白名单维护,避免隐式不兼容
幂等衔接
已产生副作用的节点不重复执行,读取执行记录直接复用结果
落地:读取节点执行记录,已成功且有副作用的节点直接复用结果
落地:执行记录以实例 ID + 节点 ID 为唯一键
落地:复用结果标记 reused=true,便于统计恢复效率
恢复动作记审计日志,支持人工指定恢复节点
落地:恢复操作全量记审计日志,含操作人、原因、恢复节点
落地:支持人工指定从某个节点重启,需二次确认
落地:审计日志保留 180 天
触发方式
自动重试(指数退避)、人工手动重跑、定时补偿任务
落地:自动重试按指数退避,最大 3 次,间隔 1s/4s/16s
落地:人工重跑在控制台操作,需权限校验
落地:定时补偿任务扫描长期失败实例,按策略重试或转人工
工具调用幂等保护
幂等键设计
幂等键 = 流程实例 ID + 节点 ID + 业务唯一键,写入 Redis / DB 唯一索引
落地:幂等键 = 实例 ID + 节点 ID + 业务唯一键,写 Redis 与 DB 唯一索引双保险
落地:调用前查键,命中直接返回上次结果
落地:键值带业务语义,禁止用随机数导致幂等失效
调用前查键,命中则直接返回上次结果
落地:先查 Redis,未命中再查 DB,均未命中才真正调用
落地:调用成功后立即写键,写失败则回滚并报错
落地:查询与写入加分布式锁,防止并发穿透
副作用防护
写操作统一走「先落库预占 → 调外部 → 回写结果」两阶段
落地:写操作先落库预占(状态 processing),再调外部接口
落地:外部成功回写结果置 success,失败置 failed 并释放预占
落地:预占记录带超时,超时未回写由补偿任务处理
外部接口优先使用其原生幂等参数(如 request_id)
落地:外部接口优先使用其原生幂等参数(request_id、业务单号)
落地:无原生幂等能力时,先查询外部状态再决定是否重试
落地:接口幂等能力登记在工具注册中心,供编排层参考
异常处理
超时不确定结果时,先查询外部状态再决定重试
落地:超时后先调用外部查询接口确认实际状态
落地:确认已成功则补写结果,确认失败才重试
落地:无法确认时标记为待人工核对,不盲目重试
幂等记录设置 TTL 与归档策略,避免无限膨胀
落地:幂等记录设 TTL 7 天,超期归档到冷存储
落地:TTL 需大于业务最大重试窗口
落地:归档表按月分区,支持按业务键查询
人工介入节点
节点设计
审批节点:指派人、审批表单 Schema、通过/驳回分支、超时策略
落地:审批节点配置指派人(人或角色)、表单 Schema、通过/驳回分支
落地:超时策略支持自动通过、自动驳回、升级上级
落地:表单 Schema 与业务系统字段对齐,避免二次录入
支持会签、或签、转交、加签
落地:会签需全部通过,或签任一人通过即可
落地:支持转交与加签,均需记录操作日志
落地:多人审批结果汇总规则可配置
交互实现
生成待办任务推送(站内信 / 企微 / 邮件),带审批链接
落地:生成待办后推送站内信、企微、邮件三通道,带直达审批链接
落地:链接带一次性 token,防止越权访问
落地:推送失败重试并记录,避免待办丢失
审批结果回调唤醒挂起的流程实例
落地:审批完成后回调流程引擎接口,携带审批结果与实例 ID
落地:引擎校验合法后唤醒挂起实例,从审批节点继续执行
落地:回调做幂等,重复回调只生效一次
治理
审批留痕:操作人、意见、时间、修改前后值
落地:记录操作人、意见、时间、修改前后值,全量留痕
落地:留痕数据不可修改,仅可追加
落地:支持按流程实例导出审批记录,满足审计要求
权限校验:只有被指派人可操作,超时自动升级
落地:只有被指派人可操作,服务端校验身份与角色
落地:超时未处理自动升级到上级并通知
落地:越权操作记录安全日志并拒绝
技术栈与工程实现
技术栈:LangChain / LangGraph / SpringAI
落地:Java 技术栈用 SpringAI 承载 LLM 调用与工具编排
落地:复杂图流程用 LangGraph,简单链式用 LangChain
落地:框架能力封装为内部 SDK,避免业务直接依赖框架 API
模型网关与成本治理
多模型路由网关
落地:网关统一收口所有模型调用,按模型、租户、场景配置路由规则
落地:路由支持权重、灰度、按成本优先三种策略
落地:网关无状态部署,配置从配置中心热加载
模型降级
落地:主模型超时或限流时自动降级到备用模型(同能力等级)
落地:降级规则按场景配置,核心场景不降级到弱模型
落地:降级次数与效果纳入监控
故障切换
落地:多供应商多可用区部署,健康检查失败自动摘除
落地:故障切换在 3 秒内完成,切换过程对业务透明
落地:切换事件告警并记录,便于复盘
RPM / TPM 限流
落地:按租户与模型维度设 RPM/TPM 配额,令牌桶限流
落地:超限返回 429 并提示重试,不排队阻塞
落地:配额可动态调整,大客户单独提额
token 用量审计
落地:每次调用记录模型、token 数、耗时、租户、场景
落地:按天聚合出成本报表,支持按部门分摊
落地:异常用量(突增 3 倍)自动告警
语义缓存:控制推理成本
落地:query 向量化后先查语义缓存,相似度 ≥ 0.95 直接返回
落地:缓存只对确定性场景开启,含用户私有数据的请求不缓存
落地:缓存 TTL 按知识时效设定,过期自动失效
上下文压缩:控制推理成本
落地:历史对话超长时用 LLM 摘要压缩,保留关键实体与结论
落地:按 token 预算裁剪上下文,优先保留最近轮次与检索结果
落地:压缩前后做信息完整性抽检
模型分级路由:控制推理成本
落地:按任务难度分级,简单分类用小模型,复杂推理用大模型
落地:分级规则由路由层判定,可用小模型做难度分类
落地:分级效果通过准确率与成本双指标评估
端到端项目闭环
AI 项目方案论证
落地:方案论证输出业务价值、技术可行性、成本估算三份材料
落地:明确验收指标与 ROI 计算口径,与业务方对齐签字
落地:风险清单同步列出,含数据合规与依赖风险
原型验证
落地:2~4 周完成最小可用原型,覆盖核心链路
落地:用真实数据小样本验证效果,输出效果基线
落地:原型验证不追求工程完备,重点验证可行性
压测
落地:用生产同构环境压测,覆盖峰值 QPS 的 1.5 倍
落地:关注 P99 延迟、错误率、资源水位三项指标
落地:压测暴露的瓶颈先修复再上线
灰度上线
落地:按用户或租户分桶灰度,首批 5% 流量
落地:灰度期间监控核心指标,异常一键回滚
落地:灰度周期不少于一周,覆盖业务高峰
迭代优化
落地:上线后按周复盘指标,收集用户反馈形成迭代清单
落地:迭代按价值排序,小步快跑,每次改动过回归
落地:劣化项优先修复,不叠加新功能
打通大模型能力与现有业务系统
落地:通过 API 与消息接入现有业务系统,避免改造核心系统
落地:统一身份与权限对接,复用企业 SSO
落地:接入过程做数据一致性校验
量化业务价值,实现业务赋能与 ROI 评估
落地:量化指标含人力节省、处理时效提升、错误率下降
落地:按季度输出 ROI 报告,折算成本与收益
落地:ROI 不达预期的场景及时止损或调整方案
Single Agent
基于 Function Calling / MCP 实现业务 Agent 编排
工具接入
Function Calling:OpenAPI Schema 描述工具,模型输出结构化调用参数
落地:工具以 OpenAPI Schema 描述,注册到工具中心供模型选择
落地:模型输出结构化参数,服务端校验后执行
落地:参数校验失败把错误信息回传模型让其修正
MCP:统一 MCP Server 注册工具、资源与提示词,客户端动态发现
落地:部署统一 MCP Server,注册工具、资源与提示词
落地:客户端启动时动态发现工具列表,无需硬编码
落地:MCP Server 做鉴权与限流,按 Agent 授予工具范围
工具注册中心:名称、描述、参数 Schema、超时、鉴权、限流
落地:工具注册中心维护名称、描述、参数 Schema、超时、鉴权、限流
落地:工具上线需审核,描述质量直接影响模型选择准确率
落地:工具版本化管理,旧版本保留供存量 Agent 使用
编排实现
ReAct 循环:思考 → 调工具 → 观察 → 再思考,设最大轮次(如 10)
落地:ReAct 循环按思考→调工具→观察→再思考执行,最大轮次 10
落地:每轮把工具结果裁剪后入上下文,避免超窗
落地:达到最大轮次强制收敛,输出当前结论
参数校验与修正:Schema 校验失败回传错误让模型重试
落地:工具参数按 Schema 校验,失败时把错误详情回传模型重试
落地:连续 3 次校验失败则终止并降级
落地:校验失败样本记录,用于优化工具描述
结果裁剪:工具返回值超长做摘要后再入上下文
落地:工具返回超 2000 token 时先摘要再入上下文
落地:结构化结果只保留关键字段,其余存引用地址
落地:裁剪规则按工具类型配置
安全与治理
工具白名单 + 权限校验,高危工具需二次确认
落地:工具白名单按 Agent 授权,未授权工具不可见
落地:高危工具(写操作、支付)需二次确认或人工审批
落地:权限校验在服务端执行,不依赖提示词约束
全量工具调用日志、耗时、成功率监控
落地:记录每次工具调用的入参、出参、耗时、成功与否
落地:按工具维度统计成功率与 P99 延迟,异常自动告警
落地:日志脱敏后存储,保留 90 天
单智能体承载业务场景任务
角色定义
系统提示词定义角色、目标、可用工具、输出格式与拒绝边界
落地:系统提示词定义角色、目标、可用工具、输出格式与拒绝边界
落地:拒绝边界明确列出不可回答的问题类型
落地:提示词版本化管理,改动过回归测试
上下文注入:用户画像、业务规则、少量示例(Few-shot)
落地:注入用户画像、业务规则与 2~3 条 Few-shot 示例
落地:注入内容按 token 预算裁剪,优先保留业务规则
落地:敏感画像字段脱敏后再注入
记忆机制
短期记忆:会话窗口 + 摘要压缩
落地:短期记忆保留最近 10 轮对话,超出部分摘要压缩
落地:摘要保留关键实体、结论与未完成事项
落地:会话窗口按模型上下文窗口动态调整
长期记忆:用户偏好与历史结论写入向量库,按需检索召回
落地:用户偏好与历史结论写入向量库,按 user_id 隔离
落地:每轮对话前检索相关记忆注入上下文
落地:记忆设时效与置信度,过期记忆不召回
执行框架
单 Agent 循环:规划 → 工具调用 → 结果整合 → 输出
落地:单 Agent 循环按规划→工具调用→结果整合→输出执行
落地:每步结果写入会话状态,支持中断续聊
落地:循环设最大步数与 token 预算
状态持久化到会话存储,支持中断续聊
落地:会话状态存 Redis + MySQL,含历史消息与中间结果
落地:用户重新进入时加载状态继续对话
落地:状态设 TTL,超期归档
质量保障
输出 Schema 校验、幻觉检测、超轮次终止
落地:输出按 Schema 校验,不合规则重试或降级
落地:幻觉检测用引用校验与事实核对
落地:超轮次或超预算强制终止并返回已得结论
失败兜底:转人工或降级为纯问答
落地:连续失败或置信度低时转人工坐席
落地:降级为纯问答模式,仅返回检索原文摘要
落地:兜底触发次数纳入监控
AI 全链路可观测与安全护栏
LLM 全链路监控体系
调用链路
落地:用 OpenTelemetry 串联网关、检索、模型、工具全链路 trace
落地:trace_id 透传到各服务,日志按 trace_id 聚合
落地:链路拓扑可视化,支持按耗时排序定位瓶颈
延迟
落地:分段埋点记录检索、重排、首 token、完整响应延迟
落地:按 P50/P95/P99 分位统计,P99 超阈值告警
落地:延迟归因到具体环节,指导优化优先级
token 消耗
落地:每次调用记录输入输出 token 数,按模型与租户聚合
落地:token 消耗异常增长触发告警
落地:数据接入成本报表,支持预算管控
模型输出指标
落地:监控输出长度、拒答率、引用覆盖率、格式合规率
落地:指标按模型版本对比,评估升级效果
落地:异常波动自动告警并关联变更记录
Guardrail 安全能力
输入注入防护
落地:输入侧做提示词注入检测(规则 + 分类模型),命中即拦截
落地:系统提示词与用户输入严格分隔,禁止用户输入改变系统指令
落地:拦截事件记录并告警
输出校验
落地:输出侧做敏感词、PII、违规内容校验
落地:校验不通过则拦截并返回安全提示
落地:校验规则可配置,支持行业合规模板
敏感信息脱敏
落地:识别身份证、手机号、银行卡等 PII 并做掩码替换
落地:脱敏在返回前统一执行,日志存储同样脱敏
落地:脱敏规则与合规要求同步更新
Multi Agent
多智能体协作编排
协作模式
主管-执行(Supervisor):调度 Agent 分派子任务并汇总
落地:Supervisor Agent 拆解任务、分派子 Agent 并汇总结果
落地:子 Agent 只接收子任务与必要上下文,避免信息过载
落地:汇总阶段做冲突消解与结果校验
流水线(Sequential):上游输出作为下游输入
落地:上游 Agent 输出作为下游输入,按固定顺序串联
落地:每步输出做 Schema 校验,失败中断并回传错误
落地:流水线支持断点续跑,复用上游结果
辩论/评审(Debate):多 Agent 并行产出后交叉评审择优
落地:多 Agent 并行产出后交叉评审,按评分择优
落地:评审维度与权重可配置,避免同质化投票
落地:评审结论记录,便于分析各 Agent 表现
通信与状态
共享消息总线或共享黑板(Blackboard),统一消息 Schema
落地:共享黑板存任务状态与中间结果,统一消息 Schema
落地:消息总线用 MQ 或 Redis Stream,按任务 ID 分区
落地:黑板数据设版本号,避免并发覆盖
任务队列分发,子任务状态与结果集中存储
落地:任务队列按优先级分发,子任务状态集中存储
落地:子任务超时未完成自动回收并重派
落地:队列积压监控,超过阈值扩容消费者
可靠性控制
最大轮次与总 token 预算,超限强制收敛
落地:设最大轮次与总 token 预算,超限强制收敛输出当前结论
落地:预算按任务复杂度动态分配
落地:超限事件记录,用于优化任务拆解策略
死循环检测、子任务超时、失败重试与降级
落地:检测重复调用与状态不变循环,连续 2 次相同即中断
落地:子任务设超时,失败按策略重试或降级
落地:降级时返回部分结果并标注不完整
全链路 trace 串联各 Agent 调用,便于定位
落地:trace_id 贯穿所有 Agent 调用,串联完整执行链
落地:每个 Agent 的输入输出、耗时、token 都记入 trace
落地:支持按 trace 回放,定位协作失败环节
与 Single Agent 同属 Agent 编排能力层
分层关系
Single Agent 是执行单元,Multi Agent 是编排层,共用工具注册中心与记忆存储
落地:Single Agent 作为执行单元,Multi Agent 作为编排层
落地:两者共用工具注册中心与记忆存储,避免能力重复建设
落地:分层边界清晰,编排层不承载具体业务逻辑
复用设计
Agent 以配置(角色、工具集、模型)形式注册,可被单 Agent 与多 Agent 复用
落地:Agent 以配置(角色、工具集、模型、提示词)形式注册
落地:同一 Agent 配置可被单 Agent 与多 Agent 场景复用
落地:配置版本化管理,变更走灰度
统一运行时:同一套执行引擎承载单/多 Agent 与 Workflow 节点
落地:统一运行时承载单 Agent、多 Agent 与 Workflow 节点执行
落地:执行引擎统一处理超时、重试、状态持久化
落地:新增形态只加适配层,不改运行时内核
收藏
立即使用
收藏
立即使用

收藏
立即使用

收藏
立即使用


Collect
Get Started

Collect
Get Started
Collect
Get Started

Collect
Get Started
评论
0 条评论
下一页

