七贝 AI
2026-10-29 16:15:35 0 举报仅支持查看
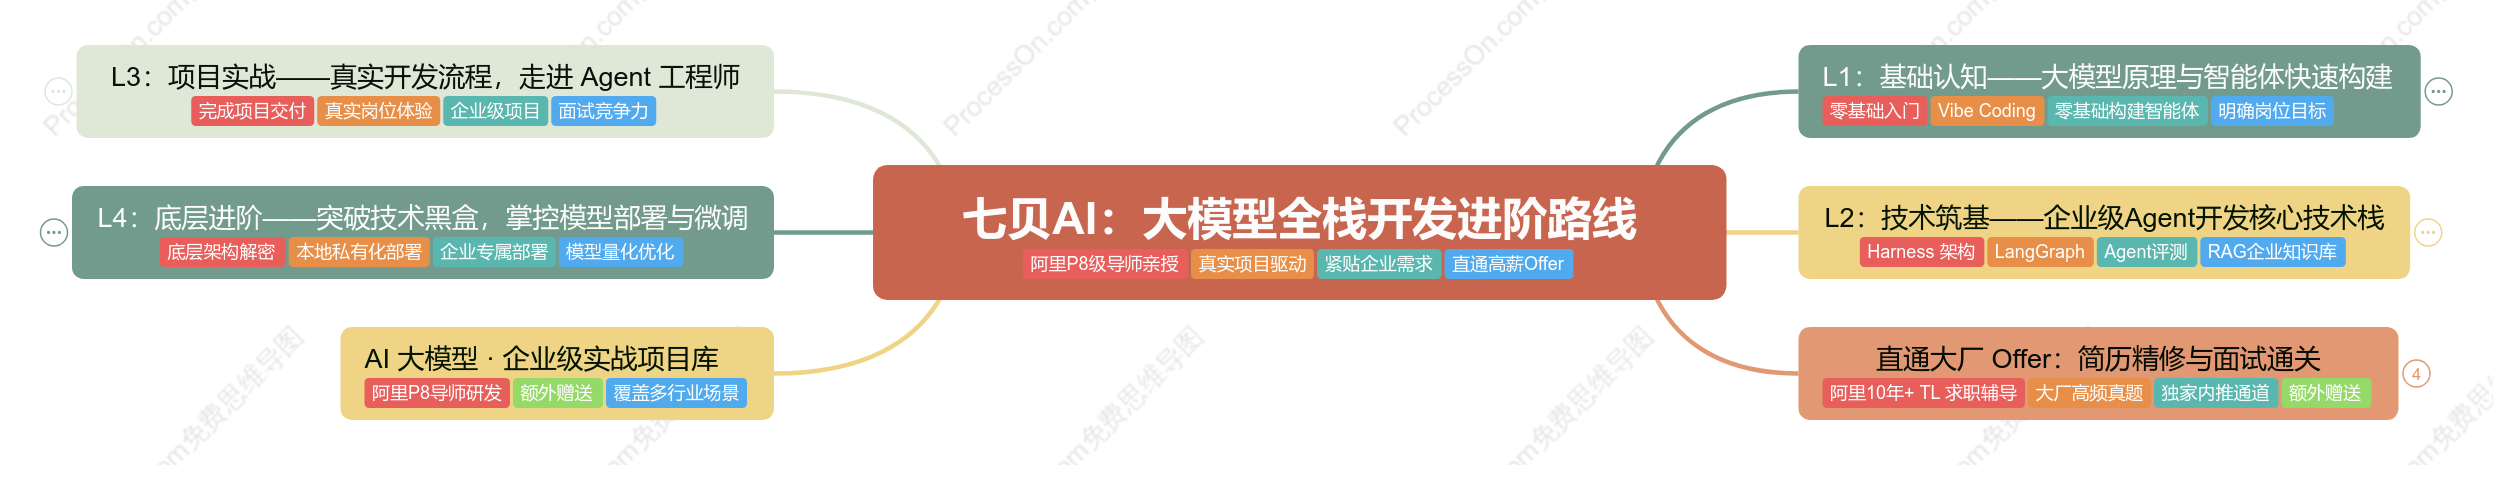
七贝 AI:大模型全栈开发进阶路线
大模型
Agent
AI全栈
模板推荐
作者其他创作
大纲/内容
L1:基础认知——大模型原理与智能体快速构建
L1学习目标
构建技术认知
看懂大模型原理,明确能力边界;理解 Prompt、RAG、Agent、微调的核心作用<br>
明确学习路线
对标企业岗位要求,抓准核心技能;明确从理论学习到求职就业的完整路径
完成首个 Agent
掌握 Vibe Coding 与 AI 编程工具;从 0 到 1 独立开发首个智能体
大模型理论基础体系
初识大模型
课程全景图谱与进阶导引
AI技术演进编年史
大模型底层原理解析
大模型与 AGI 的区别与边界
大模型核心专业术语精讲
主流大模型与生态应用
主流大模型全景图<br>
国内头部大模型<br>
海外主流大模型
现象级大模型应用产品解析
国内应用生态
海外应用生态
大模型行业落地与就业红利
大模型+电商
大模型+法律
大模型+医疗
大模型+教育
更多垂直行业赋能......
大模型的演进与未来
行业发展趋势前瞻
能力边界与局限性
突破能力边界
Prompt(提示词)
RAG(检索增强生成)
Agent(智能体)
Fine-tuning(模型微调)
职业发展与未来
AI时代程序员岗位图谱
AI赋能传统开发范式
AI应用开发/Agent开发工程师
AI时代开发者常用软件安装【选修】
环境配置类
编程语言环境
Python
Node.js
数据库与版本控制
Git
MySQL
环境管理
Anaconda
UV
常用开发工具类
代码编辑器
VS Code
数据库管理
DBeaver
AI应用与工作流平台
Dify
FastGPT
n8n
网络与环境辅助
科学工具
Vibe Coding 工具
CodeX(ChatGPT)
Claude Code
DeepSeek Harness
Qoder
全栈工程底座 【选修】
编程语言
Python
不同系统中搭建Python编程环境
Windows
Mac
基础语法
第一个 Hello World
注释
单行注释
多行注释
变量
变量本质:标签而非容器
变量命名规则
变量赋值
链式赋值
多元赋值
交换变量
*号解包:捕获剩余元素
运算符
计算运算符
加减乘除 +-*/
整除 //
取余 %
幂运算 **
比较运算符
大小比较 > < >= <=
(不)等于 != ==
身份比较 is
逻辑运算符
与 and
或 or
非 not
位运算符
移位 >> <<
按位与 &
按位或 |
按位异或 ^
按位取反 ~
数据类型与容器
数据类型
整型 int
浮点型 float
布尔类型 bool
字符串类型 str
类型切换
复数 complex
数据容器
列表 list
元组 tuple
集合 set
字典 dict
输入与格式化输出
input( )
Python 的格式化输出
f-string方法(推荐)
% 占位符格式化(了解即可)
输出换行控制
流程控制
if
单分支
双分支
多分支
分支嵌套
循环
while
for
循环控制
break
continue
pass
循环嵌套
函数
基础语法
调用函数
定义函数
函数的参数
位置参数
关键字参数
默认参数
可变参数
工程化规范(Agent 工具核心)
类型注解(Type Hints)
文档字符串(Docstrings)
高级特性
作用域与闭包
Lambda
装饰器(Decorator)
生成器(yield)
异步编程(Agent高并发与性能核心)
协程基础(async / await)
并发执行(asyncio.gather)
面向对象编程
理解面向对象
什么是面向对象
面向对象与面向流程的区别
类和对象的关系
核心基础
类与对象
属性与方法
实例化
构造方法
三大特性
封装
继承
多态
异常与文件处理
异常处理
基本概念
什么是异常
异常对象捕获
异常捕获机制
基础捕获
多分支捕获(分类处理)
统一捕获(合并处理)
全局捕获(except Exception)
控制流扩展
异常中的 else
finally 子句(资源释放)
异常抛出
主动抛出(raise)
自定义异常类
函数与异常
异常传播机制(向上抛出)
文件操作
打开与配置
文件模式(读写/追加/二进制)
上下文管理器(with 语法)
缓存与编码(encoding)
基本文件操作
读与写(Read / Write)
按行读写(Readline / Writelines)
文件关闭(close)
文件系统管理(OS)
文件重命名(rename)
文件删除(remove)
高效内容迭代
按字节处理
按行遍历
懒加载式迭代(大文件处理机制)
迭代器与生成器(yield)
内存文本处理
内存流处理(StringIO / BytesIO)
序列化与反序列化
通用序列化(Pickle 等)
JSON 序列化与反序列化【重点】
Web框架
FastAPI
1. FastAPI框架入门
1.1 核心概念
RESTful API 设计规范
ASGI 异步协议
核心依赖:Starlette、Pydantic
1.2 环境与启动
虚拟环境 (virtualenv)
启动命令 (uvicorn --reload)
1.3 接口文档本地化
离线下载静态资源
修改源码并挂载本地目录
2. 路由与请求参数
2.1 路由控制
路由装饰器 (@app.get/post)
路由分发 (APIRouter、include_router)
路径参数 (类型约束、Enum枚举)
2.2 查询参数
Query 校验 (长度、正则、大小)
可选参数 (Union / List)
2.3 请求体传参
Pydantic 模型 (BaseModel)
嵌套模型与 Field 约束
自定义校验 (@field_validator)
3. SQLAlchemy模型定义
3.1 数据库引擎
连接配置 (URL 格式、连接池)
3.2 模型定义
声明式基类 (DeclarativeBase)
字段映射 (Mapped、mapped_column)
常用约束 (主键、非空、唯一)
3.3 数据库迁移 (Alembic)
初始化与配置 (env.py)
迁移命令 (revision、upgrade)
4. Session的相关操作
4.1 事务管理
手动提交 (begin / commit)
自动提交 (begin() 上下文)
4.2 基础操作 (CRUD)
新增 (add / insert)
查询 (execute、scalars、text)
修改 (属性赋值 / update)
删除 (delete)
4.3 高级查询
条件过滤 (like、in_、and_、or_)
聚合与分组 (func、group_by)
排序与分页 (order_by、limit、offset)
5. 模型关联关系
5.1 一对多/多对一
外键 (ForeignKey)
关联属性 (relationship、back_populates)
级联操作 (cascade)
树形自关联 (remote_side)
5.2 一对一
约束配置 (single_parent=True)
5.3 多对多
中间表 (Table、联合主键)
关联属性 (secondary)
5.4 关联查询
连表查询 (join、isouter)
复杂查询 (子查询、别名)
6. FastAPI与SQLAlchemy整合
6.1 定义数据模式
继承 BaseModel
开启 ORM 模式 (from_attributes=True)
6.2 依赖注入
Session 生成器 (yield / finally)
视图注入 (Depends)
工程实践基础
数据存储
MySQL
Redis
容器与部属
Docker
K8S
开发协同
Git
多模态大模型商业实战【选修】
文生图
文生视频
基于 Vibe Coding 快速构建自己的智能体
Vibe Coding:AI 时代的开发基石
AI 编程工具介绍与对比
国外 AI 编程工具
CodeX(ChatGPT)
Caude Code
GitHub Copilot
国内 AI 编程工具
Qoder
TRaeCode
WorkBuddy
大模型 API 调用
大模型 API 调用参数
Token 计费与调用成本
Vibe Coding 动手实操
女装尺码小助手
L2:技术筑基——企业级Agent开发核心技术栈
L2学习目标
理解 Agent 原理
拆解 LLM+Harness 架构,脱离框架“手搓” Agent,彻底搞懂 Loop、MCP 等核心机制
掌握企业级技术栈
实战 LangGraph 多智能体编排,打通 RAG 与 Text2SQL,让 Agent 精准调用企业数据
建立评测能力
掌握评测与可观测方法;用数据量化效果,快速定位问题
Agent 开发:核心技术栈
初识 Agent
Agent 架构全景
Agent的定义
Agent = LLM + Harness
Agent 与 传统 WorkFlow 的本质区别
Agent 技术栈与框架生态
主流 Agent 框架
原生 Agent 开发
LangChain
LangGraph
AutoGen
Pi
……
Agent 在企业场景的落地场景
一、业务流程自动化
电商流程自动化
订单处理
客服
库存管理
招聘流程自动化
简历筛选
面试安排
候选人跟进
财务流程自动化
报销审批
发票处理
对账
供应链自动化
采购
物流跟踪
供应商管理
二、内容生成与创意
视频生成自动化
脚本
剪辑
字幕
发布
营销内容生成
文案
海报
社交媒体内容
文档自动化
报告
合同
方案生成
三、技术开发与运维
编程 Agent
代码生成
Code Review
Bug 修复
测试自动化
用例生成
用例执行
测试报告
运维 Agent
监控
告警
故障排查
四、知识管理与协作
企业知识库问答
制度
流程
技术文档
会议助手
纪要
待办
跟进
培训与学习助手
个性化辅导
知识推送
五、垂直行业 Agent
求职 Agent - 七贝职得
简历优化
岗位匹配
面试准备
销售 Agent
线索挖掘
客户跟进
话术建议
数据分析 Agent
报表生成
洞察发现
预测
Prompt Engineering 进阶指南
基础概念
提示词与提示工程
构建原则(清晰 / 约束 / 流程)
典型构成要素
角色(Role)
任务(Task)
要求与约束(Constraints)
示例(Examples)
工作流(Workflow)
进阶调优技巧
基础策略:零样本 / 少样本
推理增强:思维链(CoT)/ 思维树(ToT)
自我进化:自洽性(Self-Consistency)/ 反思机制(Self-Reflection)
安全与防范
提示词注入
提示词安全
Prompt 应用实战
从杂乱文本中精准抽取结构化信息
Context 工程:下一代大模型应用核心
定义与作用
核心挑战
关键技术策略
典型应用场景
Agent 四大核心组件
工具调用(Function Calling)
Function Calling 核心认知
技术本质:LLM与外部能力的桥梁
机制解析:自然语言到结构化执行的范式转换
Function Calling 实战
本地工具调用
外部API调用
数据库操作
多工具协同
规划(Planning)
React
Plan-and-Execute
Self-Ask
记忆(Memory)
短期记忆
长期记忆
感知(Perception)
MCP 模型上下文协议
什么是MCP
MCP原理
MCP三大核心组件
主机Host
客户端Client
服务端Server
MCP 传输方式
stdio 本地进程通信
Streamable HTTP (远程服务,目前行业标准)
旧版 HTTP + SSE 的演进与兼容
MCP与Function Call 的差异
MCP的应用场景
MCP的技术优势和行业价值
MCP 的开发与使用
<b> 构建自己的MCP</b>
从零开发 MCP Server
OAuth 授权与接口鉴权
MCP Inspector 调试
接入主流客户端与社区生态
常用的 MCP 客户端
charry studio
chatbox
cline
常见的 MCP 社区
MCP.SO
阿里云 MCP
ModelScope
Hugging face
awesome-mcp-servers Github
Agent Skills 把你的经验变成 Agent 的技能
什么是 Agent Skills
Skills 的定义与定位
Skills 与 Prompt 的区别
Skills 与 Tool、MCP 的配合
典型应用场景举例
Skills 的结构剖析
Skills 核心结构
SKILL.md
渐进式加载机制
Skills 的设计原则
单一职责原则
可组合性原则
渐进式降级原则
动手实现你的第一个Skills
开发一个 MCP Server 并封装成 Skill
Skills 接入 Agent 即插即用
<b>主流 Agent 实现:吃透 Harness 与 Agent Loop</b>
工具调用与 Agent Loop
课程特色:不靠框架,亲手写出 Agent 的核心循环
Function Calling 原理
大模型如何决定调用哪个工具;工具调用与结果回传的消息协议
手写 Agent Loop
思考—行动—观察循环;用终止条件、最大步数、错误回传,防止 Agent 陷入死循环
工具设计最佳实践
工具描述的写法;参数校验;并行调用与多工具协同;工具过多时的按需加载
任务规划
用 ReAct、Plan-and-Execute 让 Agent 学会拆解复杂任务
动手实战
原生 Python 开发能调用多个工具、自主规划任务的 Agent
上下文工程与记忆
课程特色:让 Agent 记得住、不跑偏、更省 Token
上下文工程
上下文的组成与窗口管理;长上下文的信息衰减问题;压缩、摘要、裁剪与隔离
Prompt 缓存
利用模型的上下文缓存机制,降低调用成本与响应延迟
短期记忆
会话状态管理与超长对话的上下文管理
长期记忆
沉淀用户画像与偏好;记忆的写入、检索与更新;存储方案选型
动手实战
能记住用户偏好、完成多步任务的个人助理 Agent
MCP 与 Skills
课程特色
一次开发,多次复用:给 Agent 接上整个工具生态
MCP 原理
Host、Client、Server 三大组件;Tools、Resources、Prompts;MCP 与 Function Calling 的区别
传输方式
stdio(本地进程通信)、Streamable HTTP(远程服务,当前标准);旧版 HTTP + SSE 的演进与兼容
MCP 开发
从零开发 MCP Server;OAuth 授权与接口鉴权;MCP Inspector 调试;接入主流客户端与社区生态
Agent Skills
Skills 的结构与 SKILL.md;渐进式加载机制;与 Tool、Prompt、MCP 的区别与配合
动手实战
开发一个 MCP Server 并封装成 Skill,让 Agent 即插即用
安全护栏与沙箱环境
课程特色
企业级 Agent 必须做到可管、可控、可审计、可隔离。
安全护栏
直接与间接提示词注入攻防;MCP 工具投毒防范;敏感信息识别与脱敏;输入输出双向拦截
权限控制
工具权限分级;高风险操作人工审批;操作审计日志
沙箱环境
为什么 Agent 执行代码和命令必须隔离;Docker 容器沙箱与云端沙箱方案;文件系统、网络与资源限制
动手实战
给 Agent 加上多层安全护栏,并让它在沙箱中安全执行代码
RAG:企业知识库开发
RAG应用开发:让大模型读懂你的业务
RAG 的核心价值与未来
LLM的局限与RAG的出现
LLM商业应用存在的短板
幻觉
知识库落后
数据安全
初识RAG
什么是RAG
RAG从基础到进阶
RAG的优点
RAG的应用场景
电商客服问答系统
企业知识库与内部问答系统
医疗辅助诊断与医学知识问答
法律条文检索与案例分析
教育与个性化学习辅导
技术文档与代码辅助开发
RAG核心三阶段:检索-增强-生成
RAG应用全链路:从理论基础到实践
数据预处理
数据清洗
针对PDF、Word等复杂文档的深度解析与结构化
数据增强
生成元数据或摘要,为后续检索铺路
图文解析
以视觉大模型解析图片、扫描件与图表,实现图文内容的可入库、可检索与可复用
数据准备阶段
数据提取
文本切割
数据向量化
数据存入向量数据库
检索生成阶段
问题向量化
数据检索
注入Prompt
LLM生成答案
RAG 评估指标和方法
评估方法
人工评估
LLM评估
评估类型
检索评估
相关性
精准度
召回率
生成评估
忠诚度
相关性
评估工具
Ragas
Ragas 技术原理
Ragas 评估实践
RAG企业应用进阶
文本分割粒度和分割算法
Rerank重排序
Embedding 技术原理与实践【选修】
核心原理
什么是向量
Embeddings 的定义
向量的基本原理
向量相似度计算
向量数据库选择指南
Milvus
Pinecone
Chroma
Qdrant
Weaviate
工程化实践
Embedding 模型API调用与本地部署
Agentic RAG:智能体调度与知识获取新范式
核心理念与架构演进
传统 RAG 的局限
Agentic RAG 的架构拓扑
路由与意图识别
多轮检索与反思
工程落地与评估
Text2SQL:语义驱动的安全直连
数据基建层
Schema 语义优化
差数模型优化
模型生成层
少样本示例
语法与方言适配
校验与执行层
SQL 语法/语义校验
自动纠错
安全管理层
最小权限原则
行列级权限控制
RAG 商业场景解析与高阶优化
RAG 商业化落地问题及解决办法
分块陷阱
解析失真
检索跑偏
信息沉底
事实幻觉
RAG高阶优化
索引优化
摘要索引
父子索引
假设性问题索引
元数据索引
检索优化
混合索引原理解读
混合索引适用场景
混合索引实现策略
检索后优化
Rerank 重排序
信息压缩
知识融合
LlamaIndex 从理论到实战【选修】
LlamaIndex 核心认知与快速入门
LlamaIndex 技术定位与生态价值
LlamaIndex 的核心定位
与 LangChain 的技术差异
LlamaIndex 的应用场景
LlamaIndex 核心概念与快速入门
Agent 与 Workflow 的差异
LlamaIndex 环境搭建
基于 LlamaIndex 的RAG应用
LlamaIndex 核心技术拆解
文档加载与解析
数据连接器
本地文件加载(PDF、Word、Excel)
网络数据抓取(HTML、API)
数据库连接
文档解析器
文件节点解析器
格式专用解析器(HTML、JSON、Markdown)
代码分割器
文本处理与分块
文本分割策略
句子分割器
Token 文本分割器
语义分割器
分块参数调优
chunk_size 与 chunk_overlap
分块质量评估
索引构建
向量索引
组合检索策略
索引构建流程
树形索引
关键词索引
知识图谱索引
简单LLM路径提取器
隐式路径提取器
动态知识图谱构建
存储管理
向量存储
Chroma
Pinecone
Milvus
文档存储
索引存储
缓存存储
自定义存储
索引维护
插入
删除
更新
刷新
文档跟踪
元数据管理
元数据提取
自定义数据
检索与查询
检索引擎
向量检索
混合检索
查询引擎
聊天引擎
检索策略优化
重排序
查询改写
评估与优化
响应评估维度
响应忠实度
查询相关性
答案准确性
评估方法
问题生成
批量评估
LlamaIndex 复杂工作流开发
工作流核心架构
事件驱动模型
事件定义与类型设计
事件触发机制
状态协同与传递
核心执行能力
多事件等待
手动触发与干预
人机协同
逐步执行
工程化保障
检查点机制
执行日志与可追溯性
错误处理与重试策略
复杂工作流编排
流程控制模式
分支
循环
并发
嵌套
状态管理
工作流状态维护
跨步骤数据传递
流式事件处理
高级扩展
工作流子类化
自定义工作流开发
插件化与模块化设计
工作流可视化与部属
工作流可视化与调试工具
服务化封装
API服务化
容器化部署
LLM Wiki:大模型自我优化知识库【选修】
什么是 LLM Wiki
出现背景
核心理念
适用场景与优势
LLM Wiki 架构设计
Raw Sources(原始数据源):只读,不可修改
Wiki(知识库):LLM 生成和维护的内容
Schema(控制协议):定义结构和规则
核心操作流程
Ingest(摄入):将原始资料导入知识库
Query(查询沉淀):从知识库检索并生成回答
Lint(健康检查):维护知识库质量和一致性
Wiki:从0到1实操
最佳实践与思考
混合方案:LLM 生成索引,人工整合
局限性与注意事项
GraphRAG 应用实战【选修】
知识图谱与 RAG 的关系
知识图谱原理
定义:实体、关系、属性的语义网络
作用:解决长文本多跳推理、知识结构化问题
知识图谱与 RAG 的差异
对比传统RAG:提升答案的精准性与可解释性
应用场景:复杂问答、行业知识库
知识图谱与Neo4j实践
Neo4j安装与实战
Neo4j 安装
FAQ知识图谱构建
知识图谱可视化
在 Dify 中构建基于 Neo4j 的客服系统
GraphRAG 实战
基于 GraphRAG 玄幻小说的关系抽取与知识图谱构建
主流Agent框架实战
Agent 核心框架
LangChain 三大框架,求职学精一个就够。<br>本课主讲 LangGraph,其余两个按需学习。
DeepAgents:开箱即用的 Harness
DeepAgents 核心架构与快速入门
技术认知
DeepAgent 技术定位与应用场景
与 LangChain / LangGraph 的关系与区别
核心组件
Agent Model(模型层)
Tools 工具系统
Middleware 中间件
Agent State 与 Runtime Context
创建与运行
create_deep_agent 基础使用
System Prompt 与工具配置
Agent 执行流程
调用方式与输出格式
自主规划与上下文工程
Agent Planning 任务规划
任务拆解与 Todo 管理
多步骤任务规划
动态调整任务计划
Filesystem 文件系统
文件读取与写入
文件搜索与浏览
工作空间与中间结果管理
Skills 技能
Skill 基本结构
SKILL.md 技能定义
Skill 加载机制
Skill 与 Tool / Memory 的差异
SubAgent 多智能体协作
SubAgent 基础
SubAgent 工作原理
主 Agent 与 SubAgent 的关系
任务委派与结果返回机制
专业 SubAgent 开发
Research Agent(研究助手)
Coding Agent(编程助手)
Review Agent(审查助手)
多 Agent 协作模式
串行协作
并行协作
多角色任务分工
Agent 上下文隔离
独立 Context Window
SubAgent 状态管理
主 Agent 与 SubAgent 信息传递
SubAgent 结果整合
工程化与综合实战
Agent 能力扩展
Sandbox 沙箱执行
RAG 与外部知识整合
长任务与持久化
Checkpoint 与任务恢复
失败重试与异常恢复
LangChain V1.2 零基础到应用开发
LangChain 基础与核心生态
LangChain 技术定位
什么是 LangChain ?
LangChain 解决了什么问题
原生 Agent 开发与 LangChain 开发的区别
LangChain 在大模型应用开发的定位
LangChain 与 LangGraph、LangSmith 的关系
LangChain 核心生态
Tools 与第三方工具生态
LangChain 与 MCP 生态
模型供应商与OpenAI
LangChain 快速上手
Python环境准备
创建项目及配置
快速上手- Agent 天气查询助手
LangChain Models
模型初始化
Model Class
init_chat_model
模型初始化参数解释
模型调用
invoke ( ) 调用
batch ( ) 批量调用
stream ( ) 流式调用
异步调用
模型结构化输出
定义输出结构
Pydantic模型(推荐)
TypeDict
JSON Schema
获取结构化结果
with_structured_output
输出解析器
模型调用工具(了解)
模型调用工具步骤
模型多工具调用
模型高级设置
模型推理
速率限制
调用配置
LangChain Agent
Agent 创建与调用
Agent 创建方式
静态模型
动态模型
Agent 调用
invoke ( ) 调用模型
异步调用模型
Prompt 提示词
基础提示词设置
动态提示词设置
Tools 工具
工具创建方式
@tool(推荐)
Pydantic
JSON Schema
工具创建总结
调用工具错误处理
Agent结构化输出
结构化输出支持的策略
ToolStrategy
Pydantic 模型(推荐)
Dataclass
TypeDict
JSON Schema
ToolStrategy 错误处理
Agent 输出模式
异步调用
流式输出
values
updates
messages
tasks
debug
checkpoints
custom
流式输出模型总结
LangChain Agent 记忆管理
短期记忆
短期记忆介绍
短期记忆使用方式
使用内存存储短期记忆
使用数据库存储短期记忆
自定义记忆状态
短期记忆访问和修改
通过 Tools 访问和修改短期记忆
@before_model 中间键操作短期记忆
@after_model 中间键操作短期记忆
State 与 Context 区别
超过 LLM 上下文解决方案
消息截断
消息删除
消息摘要
自定义策略
长期记忆
长期记忆介绍
Agent 中使用长期记忆方式
使用内存存储长期记忆
使用数据库存储长期记忆
工具中实现长期记忆读写
短期记忆和长期记忆区别总结
记忆总结案例 - 电商客服助手
LangChain 人机协同
什么是 Human-in-the-loop
HITL 使用示例和原理
中断决策类型及配置
响应中断
获取中断信息
响应中断信息
批准执行
拒绝并反馈
修改后执行
直接回复
批量响应决策
综合案例-文件管理助手
流式处理中的人机协同
HITL 生命周期
自定义 HITL
LangChain Guardrails 安全护栏
Guardrails 概述
内置 Guardrails
PII检测
redact
mask
hash
block
人工审批
自定义 Guardrails
自定义Agent执行前的防护栏
自定义Agent执行后的防护栏
多层 Guardrails 组合
LangGraph V1.2 框架深度学习
LangGraph 快速入门
LangGraph 介绍
什么是 LangGraph
核心特点
持久化
人工介入
流式输出
记忆系统
可观测性
环境搭建
创建 Python 环境
项目配置与依赖安装
配置文件
.env
env_utils.py
init_llm.py
Graph API 基础
第一个 LangGraph 案例
MessageState 与 invoke 理解
构建 Agent 案例
Functional API 简介
工作流模式与运行
构建步骤
五步设计法
完整案例代码
五大工作流模式
提示链(Prompt Chain)
并行化(Parallelization)
路由(Routing)
编排者-工作者(Supervisor-Worker)
评估器-优化器(Evaluator-Optimizer)
核心组件
ToolRuntime 与 ToolNode
本地服务与调试
从零构建 LangGraph 项目
配置解释与案例
基于现有项目构建
Python SDK 调用服务
LangGraph Studio 调试
短期记忆:Checkpointer
核心概念
Thread(线程)
Checkpoint(检查点)
Super-step(超步)
状态管理
获取当前最新状态
获取状态历史
从历史 Checkpoint 重放
手动修改状态
持久化模式与存储实现
InMemorySaver
SqliteSaver
MySQLSaver
PostgreSQL 搭建与操作
实战案例
Python 脚本直接运行
langgraph dev 部署运行
长期记忆:Store
Store 介绍
什么是 Store
Checkpointer 与 Store 对比
基本操作
初始化 Store
分页查询
语义搜索(余弦相似度原理与实现)
在 LangGraph 中使用 Store
后端存储实现
综合案例
Python 脚本运行
langgraph dev 部署运行
流式输出
流式输出模式
v2 统一输出格式
LLM Token 过滤
三种过滤方案
过滤案例
values 与 updates 使用
事件流
事件流投影
事件流示例
interleave 示例
人工介入(Human-in-the-Loop)
interrupt 机制
介绍与使用方式
暂停与恢复
交互式 HITL
常见模式
审批
审核并编辑内容
校验人工输入
多个并行中断
工具内中断
使用规则与最佳实践
子图(Subgraph)
子图介绍
通信模式
节点内调用子图
子图作为节点
子图持久化
三种持久化模式
per-invocation:子 Agent 作为工具
per-thread:子 Agent 跨调用记忆
查看子图状态
综合案例
时间旅行(Time Travel)
核心概念
Replay(重放)
Fork(分叉)
Replay 与 Fork 区别
高级用法
从指定节点恢复执行
Fork 后执行中断节点
中断中进行 Fork
容错机制
容错机制介绍
重试策略
配置参数
自定义重试逻辑
节点超时
运行超时
空闲超时
超时与重试组合
错误处理
容错默认值
多智能体框架【选修】
CrewAI
Agent 的评测与可观测性
评测是 Agent 走向生产的“准入证”
理念重塑:打破“凭感觉看效果”的研发模式,确立“以评促建”的工程准则。
质量防御体系:评测不仅仅是打分,更是防范模型幻觉、工具乱调、系统崩溃的最终防线。
多维评测体系与工程化构建
评测维度设计
基于业务场景拆解:效果维度(准确性/相关性)、体验维度(延迟/流畅度)、工程维度(成本/稳定性)。
评测集构建
分布设计:覆盖常见 Query、长尾边缘场景(Edge Cases)与对抗样本。
数据飞轮:持续从线上真实 bad case 中扩充评测集。
评测执行机制
人工评测 vs LLM-as-Judge:人工锚定基准线,利用强模型作为裁判进行规模化自动打分。
离线评测 vs 线上评测:离线沙盘测试(验证基线能力)与线上 A/B 实验(验证真实业务收益)相结合
复杂架构下的细粒度评估
核心 Agent 评测
任务成功率
工具调用准确率
执行轨迹评测
RAG & Text2SQL
RAG 评估
忠实度
相关性
召回率
Text2SQL 评估
执行准确率
语义语法正确率
低代码 Agent 编排平台【选修】
低代码平台的对比与选择
Coze
Coze 概述
什么是 Coze
为什么使用 Coze
注册 Coze
Coze 功能
工作流
插件
知识库
提示词
数据库
Coze 实战
全球AI每日简报智能体
Dify
什么是 Dify
基于 Docker 本地部署 Dify
Dify 插件开发
什么是 Dify 插件开发
插件类型
开发流程
零基础实现 Dify 插件开发
Dify 实战
二手房数据分析报表
基于多模态模型文生图、文生视频
FastGPT
n8n
智能体交互新范式:A2A【选修】
A2A工作原理
A2A协议
直通大厂 Offer:简历精修与面试通关<br>
面试必考“八股”
大厂笔试突围指南<br>
简历亮点深度包装
面试模拟与面经拆解
<div>L3:项目实战——真实开发流程,走进 Agent 工程师</div>
L3:学习目标
企业级项目经验
完整经历需求分析、架构设计、开发、评测到上线的全流程,掌握真实团队的项目交付方式
完整作品集
完成拾衣小铺的三个 AI 项目:AI 数据中台、智能经营助手、智能客服助手,全部部署上线,可现场演示
求职竞争力
学会把项目讲成面试亮点,掌握 Agent 岗位高频面试题,带着作品冲刺 Offer
项目背景:走进一家女装电商公司【拾衣小铺】
公司背景
成立时间:2019年
团队规模:约20人,3人技术团队
<b>你的角色:AI Agent 工程师</b>
业务规模:3 个平台 5 家店,在售约 300 个款,3000+ SKU,每周上新 20-30 款
价格区间:59-199 元通勤、休闲女装
业务流程
选款拿货
素材制作
多平台铺货
订单回流
发货及物流追踪
售前售后
业务痛点
数据分散
上新慢
断码超卖
客服响应慢
<b>解决业务痛点:企业级 Agent 项目 0 到 1</b>
核心项目一:拾衣AI数据中台
一、项目背景与痛点
现状:数据孤岛严重
ERP系统:订单、库存、商品数据
SRM系统:供应商、档口、拿货价、代发规则
CRM系统:会员、复购数据
5个店铺后台:淘宝、抖音、拼多多等平台数据
痛点:数据无法直接用
口径不统一:同物不同名、同名不同义
AI无法读取:没有标准化的数据接口
人工查数慢:跨5个系统导表、拼Excel,耗时2小时
二、项目定位
一句话总结
打通企业全链路系统与数据
让AI能够"随时查、看得懂、用得上"
战略定位
AI转型的数字底座:公司AI化的第一步
后续项目的基础:电商运营助手、智能客服助手
三、核心建设内容(4大模块)
1、数据底座搭建
多源数据接入:ERP、SRM、CRM、电商后台
数据清洗:解决"同物不同名、同名不同义"
统一建模:订单、库存、商品、供应商、客户
存储方案:MySQL + Redis缓存加速
2、业务能力标准化(MCP化)
MCP:Model Context Protocol,让AI调用企业能力
封装高频操作:查库存、查订单、查物流、查供应商
即插即用:未来AI助手直接调用
3、智能查数(Text2SQL)
自然语言查数:大白话→SQL查询
提示词工程:精准描述数据库结构
安全兜底:语法校验、只读限制、防注入
结果可视化:数据表格展示
4、企业知识库(RAG)
RAG:检索增强生成,AI基于真实资料回答
知识入库:商品尺码、售后政策、平台规则
核心链路:解析→切分→向量化→存储
高级检索:混合检索 + Rerank重排
体验优化:引用溯源 + 拒答机制
四、核心技术栈
数据层
多源异构数据接入
数据清洗与口径统一
统一数据建模
MySQL + Redis存储
能力层
FastAPI封装业务能力
MCP Server开发
API鉴权与权限控制
智能查数层
Text2SQL技术
提示词工程
安全兜底机制
结果可视化
企业知识库层
RAG核心链路
混合检索 + Rerank
引用溯源 + 拒答机制
质量保障与评测
RAG评测:Ragas框架
Text2SQL准确率评测
五、项目目标
提效
临时查数:2小时→1分钟
数据驱动决策:随时问随时答
奠基
沉淀核心数据资产
支撑后续AI项目
核心项目二:拾衣智能经营助手
一、项目定位
一句话总结
一个 7×24 小时在线的 AI 运营
上新更快,问题刚冒头就提醒
解决什么问题
上新重复劳动多:每周上新20–30款,每款按3个平台分别写标题、文案、定价
问题发现慢:断码、漏发、物流异常全靠人工,总是慢一步
补货凭经验:没有数据支撑,全凭老板感觉
二、核心功能(6大模块)
1、多平台智能上新
差异化内容生成:按淘宝、抖音、拼多多各自规则生成标题、卖点文案、短视频脚本、营销配图
智能定价建议:结合拿货成本、平台费率、竞品价格,给出分平台定价
人工确认发布:关键操作需人工审批后执行
2、经营晨报
自动生成日报:每天早上推送经营数据
多渠道推送:飞书或企业微信机器人
3、库存预警与补货建议
断码预警:根据销售速度提前预警
补货建议:结合档口拿货周期,给出补货方案
4、订单巡检
自动发现异常:代发超时、地址异常、疑似错发
主动推送告警
5、物流追踪
异常主动提醒:物流停滞、退回、派送异常
客服话术生成:必要时生成安抚话术
6、人工确认机制
关键操作审批:发布上新、调整价格、补货下单
人机协同:interrupt + Checkpoint 持久化与断点恢复
三、核心技术栈
1、Agent 架构
Agent Loop:原生智能体循环
LangGraph:状态图编排
Plan-and-Execute:复杂任务自动拆解
2、多智能体协作
Supervisor模式:主控调度
专业Agent分工:上新、库存、订单、物流各司其职
3、内容生成
多版本文案:基于平台规则与店铺风格
文生图模型:生成营销配图
Skills封装:各平台运营规范
4、定价策略
数据输入:成本、费率、竞品数据
规则约束:价格底线校验
大模型推理:智能定价建议
5、能力复用
MCP调用:复用项目一的数据和业务能力
数据底座:统一的数据模型和接口
6、主动服务
定时任务调度:Cron Job
消息推送:飞书/企业微信机器人
7、人机协同
interrupt机制:人工审批节点
Checkpoint持久化:断点恢复
记忆系统:长期记忆,沉淀经营偏好与历史决策
8、工程化保障
Langfuse:链路追踪与成本监控
容错机制:重试、超时、降级
四、项目目标
提效
上新时间:从一整天缩短到1小时内
三平台素材:标题、文案、配图一键生成
预警
断码预警:从"卖超了才发现"变成"提前预警"
异常订单:从人工巡检变成主动推送
决策
补货建议:数据驱动,不再纯凭经验
定价策略:成本、竞品、费率综合考量
核心项目三:拾衣智能客服助手
一、项目定位
一句话总结
懂尺码、懂情绪
深夜和大促都不掉线
解决什么问题
重复咨询多:大量相同问题反复回答
夜间无人回复:客户咨询得不到及时响应
大促人手不够:咨询量暴增,客服忙不过来
客户不满处理慢:情绪问题得不到及时安抚
二、核心功能(6大模块)
1、7×24售前答疑
尺码推荐:根据身高、体重、尺码表、历史退货反馈推荐
商品咨询:面料、色差、发货时间等问题解答
知识库支撑:基于商品资料、尺码表、售后政策的RAG
2、意图识别与分流
意图分类:咨询、下单、催发货、退换货、投诉
智能路由:按意图自动分流到对应处理流程
3、情绪识别与安抚
情绪判断:识别不满和愤怒的顾客
优先转人工:情绪激动时及时转接
安抚建议:给客服提供安抚话术
4、售后自助服务
自动查物流:订单物流状态查询
退换货政策:自动解释政策、生成售后工单
图片识别:识别顾客上传的质量问题和色差图片,辅助判断
5、安全护栏
不乱承诺:赔偿类话术拦截
隐私保护:敏感信息脱敏
及时转人工:复杂问题不硬答
6、人工客服辅助
实时推荐回复:在客服工作台旁侧边栏推荐
新人快速上手:降低培训成本
三、核心技术栈
1、意图与情绪识别
结构化输出:分类结果标准化
路由工作流:按意图分发处理
情绪判断:识别不满、愤怒情绪
2、多轮对话
上下文管理:会话状态维护
会话记忆:多轮对话连贯性
3、工具调用
MCP集成:查订单、查物流、生成工单
能力复用:调用项目一的数据和业务接口
4、多模态识别
视觉大模型:识别商品问题图片
质量判断:色差、破损等问题辅助识别
5、安全护栏
提示词注入防护:防止恶意引导
隐私信息脱敏:敏感数据保护
话术拦截:赔偿承诺类内容过滤
6、人机协同
智能转人工:判断何时转接
坐席辅助:实时推荐回复话术
7、效果评测
对话评测集:构建测试用例
LLM-as-Judge:大模型评判回答质量
回归测试:上线前质量保障
四、项目目标
自动解决
重复问题自动解决率:达到70%
减少人工重复劳动
全时段服务
夜间咨询:及时回复,不再无人值守
大促应对:咨询量暴增时少加人
客户体验
情绪识别:不满客户优先处理
尺码准确:减少因尺码问题导致的退货
项目部署与亮点提炼
三大项目联调
评测报告
工程化部署
FastAPI:服务接口
SSE流式输出:实时响应
Docker部署:容器化交付
L4:底层进阶——突破技术黑盒,掌控模型部署与微调
L4:学习目标
理解底层原理
看透大模型底层逻辑:理解 Transformer 架构与训练原理,摸清能力边界
掌握私有化部署
估算显存、选择量化方案,用主流框架把开源模型部署成可调用的服务
掌握微调方法论
了解微调适用场景,理解 LoRA 原理,掌握数据集构建、训练、评估、部署的完整流程
大模型底层原理
Transformer 架构-深度解读
大模型与传统机器学习的差异
为什么要用 Transformer
RNN 的局限
Transformer 的出现:Attention Is All You Need
核心组件
Tokenizer 分词
Embedding 嵌入
自注意力
多头注意力
位置编码
目前主流框架:Decoder-only
架构简单,训练高效
主流模型(GPT、Qwen)首选
适合生成任务(聊天、写作)
训练三阶段
2.1 预训练
读海量文本,学语言规律
成本最高,时间最长
产出:基础模型
2.2 监督微调(SFT)
用QA对训练模型"怎么回答"
成本中等,数据量小
产出:能对话的模型
2.3 偏好对齐(RLHF / DPO)
模型与人类偏好对齐
RLHF
DPO
产出:可商用模型
大模型私有化部署
大模型为什么要私有化部署
数据安全
成本控制
自主可控
Hugging Face 平台
Hungging Face 平台介绍
平台定位与核心价值
主要功能模块
社区生态与资源
模型仓库与数据及仓库
模型仓库
模型搜索与筛选
模型卡片解读
模型版本管理
数据集仓库
数据集格式与结构
数据集加载预览
模型文件结构
核心文件
config.json:模型配置
tokenizer.json 及相关文件:分词器配置
模型权重文件(.bin / .safetensors)
文件关系与加载顺序
模型下载与缓存管理
模型下载方法
在线下载
离线加载
本地缓存管理
缓存目录结构
缓存清理与迁移
自定义缓存路径
Transformers 框架基础
Auto 类族
AutoTokenizer:分词器加载
AutoConfig:模型配置加载
AutoModelForCausalLM:因果语言模型
AutoModelForSeq2SeqLM:序列到序列模型
AutoModelForSequenceClassification:分类模型
Pipeline 快捷接口
Pipeline ( ) 函数
常用任务管道(文本生成、分类、问答、翻译)
Trainer 训练框架
Trainer 类
TrainingArguments 配置
模型加载与推理
模型加载流程
从 Hub 加载
从本地加载
量化模型加载(GGUF、AWQ、GPTQ)
推理实践
文本生成(Text Generation)
文本分类(Text Classification)
问答(Question Answering)
批量推理优化
大模型本地部署实战
算力资源基础
硬件规划与显存计算
GPU 检测与显存规划
应用实战:本地部署DeepSeek-R1 模型
使用 VLLM 框架本地部署
使用 Transformers 库本地部署
使用 Ollama 框架本地部署
将本地部署模型接入到 AI 工具
大模型量化与显存优化
显存占用分析
模型权重
KV Cache
梯度与优化器
显存占用与上下文
模型数值精度
FP32 → FP16 → FP8 → INT4
数据范围与精度
低精度计算的优劣
量化技术详讲
PTQ(训练后量化):简单快速,训练完直接压
QAT(量化感知训练):精度高,但要重新训练
AWQ(激活感知):保护重要权重,性价比最优
数据精度对比
显存够 → FP16 原模型
显存紧张 → INT8 PTQ
显存很紧 → INT4 AWQ
精度要求高 → QAT
实战:Unsloth 量化
一键量化,显存减半
加速推理,保障质量
<b>模型微调:开发企业专属模型</b>
模型微调的原理
什么是模型微调
模型微调解决什么问题
基座模型与微调模型的关系
微调对模型能力的影响
模型微调与从零开发模型的区别
微调的优劣
模型微调的核心应用场景
指令理解与执行优化
输出风格定制与规范化
文本识别与要素提取
结构化数据输出
垂直领域能力增强
微调的适用边界与盲区
模型微调实践指南
全参微调 (Full Fine-tuning)
PEFT(参数高效微调)
LoRA 低秩适配微调(常用)
LoRA 的设计原理
模型权重矩阵
微调中的参数变化
全参数更新成本
低秩更新设想
低秩矩阵分解
什么是矩阵
矩阵维度
低秩矩阵的基本概念
两个低秩矩阵的结合
权重增量的表示
原生权重与低秩矩阵的关系
Adapter 适配器微调
Prompt 提示微调
Prefix 前缀微调
Freeze 冻结微调
参数冻结核心原理
性能优劣势分析
方案选型与成本
效果对比:全参微调 vs PEFT
成本核算:算力与显存消耗评估
主流微调工具
LLaMA-Factory:可视化一站式微调平台
Swift:轻量级微调框架
模型微调全流程实战
模型与数据准备
使用 Huggingface 下载模型和数据
使用 ModelScope 下载模型和数据
环境准备
成功微调的前提
Auto DL 云服务器的创建与使用
数据准备与处理
LoRA 微调实战
冻结基座模型参数
初始化 LoRA 矩阵
向前计算与权重增量
Loss 计算训练
更新 LoRA 参数
训练后 Adapter 的保存
AI 大模型 · 企业级实战项目库


评论
0 条评论
下一页

