从零手搓大模型思维导图
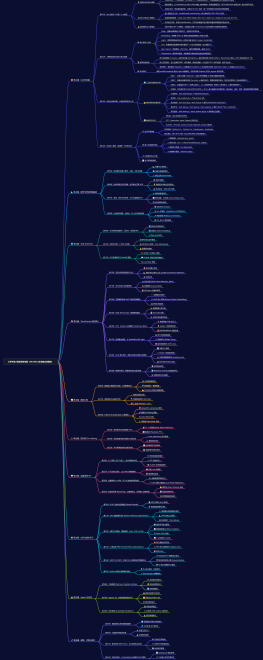
2026-09-30 10:52:59 0 举报基于经典开源项目 MiniMind 教程整理的大模型全流程实战思维导图(共42讲·10大篇章)。系统拆解:认知地基、数学与反向传播、BPE分词、Transformer核心结构(Attention/RoPE/GQA/SwiGLU/MoE)、数据清洗工程、预训练循环、SFT指令微调、RL强化学习对齐(DPO/PPO/GRPO)、Agent工具调用及工业部署评测。小白入门、算法进阶与面试复习必备全景图谱!
大模型
人工智能
Transformer
PyTorch
深度学习
模板推荐
作者其他创作
大纲/内容
🧱 第①篇 · 认知与地基
第01讲 · 为什么要从 0 手搓一个大模型
💡 直觉认知与核心愿景
打破调包侠思维:拒绝只做 API 调用者,从底层搞清「黑盒」内部究竟如何运转
大模型本质:一个超高维的「文字接龙/下一个词概率预测机」,用海量数据拟合人类语言分布规律
极致轻量化:以 MiniMind (约 26M~64M 参数) 为教学载体,单张消费级显卡(RTX 3090/4090 或笔记本)数小时即可训完
全原生手写:零封装黑盒框架,全原生 PyTorch 手撕,每一行矩阵乘法与损失回传清清楚楚
💻 核心代码与工程基准
核心模型定义文件:model/model_minimind.py(核心架构仅约 200~300 行代码)
轻量级参数规格:vocab_size=6400, hidden_dim=512, n_layers=8, n_heads=8, max_seq_len=512
动手验证任务:实例化 MiniMindLM,打印总参数量并运行随机张量前向推理验证输出形状
⚠️ 避坑要点与心智模型
目标不是和 GPT-4 拼指标,而是建立对整个 Transformer 流水线每行代码的绝对掌控感
第02讲 · 大模型极简史与核心概念地图
🗺️ 核心概念六边形
Token:模型处理的最小字符积木,非单纯汉字或字母
Embedding:将离散 Token ID 映射为高维连续稠密几何语义向量
Logits:网络顶层输出的未归一化得分向量 [Batch, SeqLen, VocabSize]
Loss:衡量模型当前猜测与语料真实下一个词之间的差距(交叉熵标尺)
Step / Epoch:参数更新一次为 Step,遍历完整数据集一遍为 Epoch
Temperature:解码采样温度,调控模型从确定性到创造性的探索旋钮
📜 极简演进脉络
统计语言模型 (N-Gram) ➔ 静态词向量 (Word2Vec) ➔ 循环神经网络 (RNN/LSTM) ➔ Transformer 架构 ➔ GPT 系列自回归大一统
核心范式辨析:区分自编码 BERT(双向掩码,做特征理解)vs 自回归 GPT(单向因果,做文本生成)
显存辨析:参数显存 (Weights) vs 梯度显存 (Gradients) vs 优化器状态显存 (Optimizer States) vs 激活值 (Activations)
💻 动手验证
查看 model.forward(x) 输出 Logits 张量维度,手动对其做 Softmax 并对比 argmax 采样结果
第03讲 · 训练全流程鸟瞰:大模型的四阶段人生
🔄 工业级大模型流水线
阶段一:训练分词器 (Tokenizer) ➔ 建立字符到整数 ID 的双向编解码映射表
阶段二:海量无监督预训练 (Pre-train) ➔ 通读万卷书,掌握语言基本语法、常识与世界知识(输出接龙能力)
阶段三:监督微调 (SFT) ➔ 角色认知注入,从「无差别续写」转变为「遵守指令、礼貌作答的助手」
阶段四:对齐强化学习 (RLHF/DPO/GRPO) ➔ 引入人类价值偏好与奖励机制,输出安全、诚实、有用(甚至激发慢思考推理)
📂 脚本矩阵与权重传承
分词脚本:train_tokenizer.py ➔ 生成 tokenizer.json
预训练:train_pretrain.py ➔ 产出 pretrain.pth
指令微调:train_full_sft.py / train_lora.py ➔ 继承 pretrain.pth 产出 sft.pth
强化学习:train_dpo.py / train_ppo.py / train_grpo.py ➔ 继承 sft.pth 产出 rl_model.pth
演示服务:web_demo.py / serve_openai_api.py ➔ 端到端交互部署
📊 数据形态对应
预训练:纯文本连续长字符串
SFT:[Instruction, Input, Output] 多轮对话
RL/DPO:[Prompt, Chosen_Answer, Rejected_Answer] 偏好对
第04讲 · 环境与工具链:跑通第一行训练代码
🛠️ 运行环境准备
开发依赖:Python 3.9+、PyTorch 2.x、Transformers、Accelerate
算力建议:单卡 RTX 3060 12G/3090/4090 均可流畅运行
⚙️ 最小训练循环骨架
1. 清零梯度:optimizer.zero_grad()
2. 前向计算:loss = criterion(model(inputs), targets)
3. 误差反向传播:loss.backward()
4. 参数单步更新:optimizer.step()
🚀 训练稳定性三件套
混合精度训练 (AMP):torch.cuda.amp.autocast() + GradScaler() 减少显存消耗并加速
梯度累积 (Gradient Accumulation):以较小显存通过累积步数模拟大 Batch Size 效果
梯度裁剪 (Gradient Clipping):torch.nn.utils.clip_grad_norm_() 强行限制梯度模长,避免梯度爆炸
📉 学习率调度策略
Warmup 预热(前期平滑爬升保护随机权重)+ Cosine 余弦衰减(后期平稳收敛)
📐 第②篇 · 数学与神经网络基础
第05讲 · 够用就好的最小数学:向量、点积与梯度
📐 向量与几何表征
词语在空间中的坐标:高维空间中的点与方向,相似语义聚集在相近空间区域
点积 (Dot Product):u · v = Σ u_i v_i = |u||v|cos(θ),衡量两段向量的共线性与相关度,Attention 的基础算法
🧭 导数与梯度指南针
导数:标量函数的瞬间变化率;偏导数:多元函数沿单轴的变化率
梯度 (Gradient):函数在某点上升最快的方向;梯度下降即沿着梯度反方向迈步更新,使 Loss 持续下降
🔗 链式法则 (Chain Rule)
复合函数求导法则:dL/dx = (dL/dy) * (dy/dx),反向传播算法的底层数学基石
自动求导实战:验证 PyTorch torch.autograd 如何在计算图 (Computational Graph) 上自动回溯梯度
第06讲 · 神经网络与反向传播:亲手教会它算 XOR
🧠 神经元模型
感知机结构:加权求和 + 偏置偏置项 + 激活函数映射 y = σ(w^T x + b)
非线性的必然性:单层感知机只能解决线性分割问题,无法拟合异或 (XOR) 逻辑门(Minsky 世纪之问)
💡 隐藏层与非线性空间扭曲
引入隐藏层 + 激活函数:将输入空间弯曲折叠,将线性不可分问题映射到高维线性可分空间
💻 动手实战:手写 XOR 网络
代码构造:输入维度 2 ➔ 隐藏层 4 ➔ 输出维度 1,利用两层 MLP 从零学习 XOR 逻辑
反向传播可视化:亲手打印每一层的权重变化与损失下降过程
第07讲 · 激活、损失与优化器:为什么偏偏选它们
⚡ 激活函数演进史
Sigmoid / Tanh:两端极易饱和导致梯度消失 (Vanishing Gradient),已退出 Transformer 隐层主流
ReLU:计算极快但存在 Dying ReLU(神经元永久死亡失活)缺陷
GELU:引入高斯随机正则思想的平滑激活函数,BERT/GPT-2 标配
SwiGLU:Swish/SiLU 与门控线性单元结合:x ⊗ SiLU(Gate(x)),大模型(LLaMA/MiniMind)当红王者
📉 损失函数:交叉熵 (Cross Entropy Loss)
信息论本质:衡量模型输出概率分布 P 与真实标签 One-Hot 分布 Q 的 KL 散度距离
公式化简:L = -log(P_true),目标就是让真实下一个词的预测概率无限逼近 100%
⚙️ 优化器进阶路线
SGD:基础随机梯度下降,易陷入鞍点与剧烈震荡
Momentum:引入一阶动量惯性,冲过狭窄沟壑与局部极值
Adam:一阶动量 + 二阶梯度平方历史自适应调节步长
AdamW:解耦权重衰减 (Decoupled Weight Decay),解决传统 L2 正则与 Adam 自适应缩放耦合的过拟合问题
第08讲 · 让网络训得稳:正则化、归一化与残差连接
🛡️ 过拟合与 Dropout
直觉:随机关掉一部分神经元,防止网络死记硬背训练样本
工程实现:训练时按概率 p 置零,未置零节点乘 1/(1-p) 进行尺度补偿;推理时全部开启
⚖️ 归一化演进:LayerNorm vs RMSNorm
BatchNorm 依赖 Batch 维度在自回归长序列中表现极差,NLP 采用 LayerNorm 针对单样本特征维归一化
RMSNorm (均方根归一化):移除了均值计算,仅保留均方根缩放:x / sqrt(mean(x^2) + ε) * γ
收益:计算速度提升 20%~30%,数值稳定性分毫不差,MiniMind 全面采用 RMSNorm
🚀 残差连接 (Residual Connection)
公式:x_{l+1} = x_l + F(x_l)
物理意义:给反向传播梯度流打通一条无阻碍直通高速公路 (dL/dx_l = dL/dx_{l+1} * (1 + ...)),根除深层网络梯度消失
🏗️ Pre-Norm 架构选择
Pre-Norm(进入注意力/FFN 前归一化)相比 Post-Norm(原始 Transformer)拥有远超寻常的训练收敛稳定性
🔤 第③篇 · 分词 Tokenizer
第09讲 · 文字如何变成数字:从按字、按词到 BPE
🔠 常见分词方案对比
按字分词 (Char-level):词表极小,但序列超长,语义碎片化,中文单字歧义严重
按词分词 (Word-level):序列短,但词表爆炸(数十万),无法处理未登录词 (OOV, Out-Of-Vocabulary)
子词分词 (Subword / BPE):完美折中方案,高频整词保留,生僻词拆解为子词或字节组合,彻底杜绝 OOV
🔢 词表与 Token Embedding
词表 (Vocab):Token 字符串到整数 ID 的映射字典字典表
Embedding 层:nn.Embedding(vocab_size, hidden_dim),本质就是一张可训练的高维特征查找表
🧩 Byte-level BPE
以 UTF-8 基础字节 (0~255) 为基本单位,任何汉字、拉丁字母、罕见 Emoji 都能被无损表示
第10讲 · 手把手训练一个 BPE 分词器
⚙️ BPE 核心合并算法
1. 初始状态:将所有语料切分为基础单字节序列
2. 统计共现:统计相邻字符对 (Pair) 的频次
3. 贪婪合并:选出频次最高的 Pair(例如 '大' + '模型' ➔ '大模型')合并为新 Token 扩充到词表
4. 迭代循环:重复步骤 2~3,直至词表扩充到预设目标尺寸
💻 MiniMind 实践:train_tokenizer.py
采用 Hugging Face tokenizers 库原生编写训练流程
词表规模精选:定为 6400(轻量化与中文表达力的黄金平衡点,相比动辄 100K 词表极度节省 Embedding 参数显存)
⚠️ 重要避坑指南
下游预训练、SFT 必须严格使用同一套 Tokenizer,绝不能中途修改或重新训练分词器,否则权重彻底错位报废
第11讲 · 中文处理的坑与 ChatML 铺垫
🇨🇳 中文的「分词税」现象
中文单个汉字在 UTF-8 编码下占 3 字节,若分词器中文覆盖率低,一个汉字会被切为 3 个 token,导致模型推理极慢且计算浪费
针对性优化:在训练 BPE 时混合足量高质量中文语料,让常用双字词、成语独立成词
💬 ChatML 多轮对话标准格式
格式规范:<|im_start|>role
content<|im_end|>
三大核心角色:system(设定性格与规则)、user(用户输入)、assistant(模型回复)
价值:用不可伪造的特殊边界 Token 彻底理清说话人身份,防范 Prompt 越狱注入攻击
🎭 Loss Mask 预留
生成多轮对话 targets 时,只有 assistant 区域计算 loss,其余 system/user 区域设为 -100 屏蔽
🧠 第④篇 · Transformer 结构核心
第12讲 · 注意力机制的直觉与公式
🎯 动态划重点本质
根据当前词的需求动态审视上下文全部词汇,给相关度高的词分配更大权重
📐 缩放点积注意力公式 (Scaled Dot-Product Attention)
公式:Attention(Q, K, V) = Softmax( (Q K^T) / sqrt(d_k) ) V
Query (Q):我在找什么;Key (K):我有什么属性;Value (V):我的具体内容
为何除以 sqrt(d_k):维度较大时点积方差膨胀,Softmax 容易进入饱和区导致梯度极小,缩放可保持方差为 1
💻 代码对齐
model/model_minimind.py 中的自研 Attention 实现,以及与 PyTorch 内置 scaled_dot_product_attention (SDPA) 对齐
第13讲 · 多头注意力与因果掩码
👥 多头机制 (Multi-Head Attention, MHA)
将高维隐藏特征切分为 h 个互不干扰的低维子空间,分别并行计算注意力
优势:允许模型在不同头中同时关注语法修饰、代词指代、长程时态与逻辑关联
流程:拆分多头 ➔ 并行注意力 ➔ 跨头拼接 ➔ 线性投影输出
🙈 因果掩码 (Causal Mask)
单向自回归要求:模型预测第 t 个词时,严禁窥探第 t+1 及以后的未来词汇
实现:构建下三角矩阵 (Lower Triangular Matrix),上三角全部填入 -inf,经过 Softmax 变为严格的 0
🛡️ QK-Norm 防爆炸细节
进入 QK 点积前对 Q 和 K 做 RMSNorm,极大增强深层网络长文本数值稳定性
第14讲 · 位置编码革命 RoPE (旋转位置编码)
📍 位置编码必要性
Attention 本质是集合运算,无视顺序(置换等变性),必须向特征向量显式注入序列顺序信息
🌀 RoPE 核心机理 (Rotary Position Embedding)
将绝对位置信息以旋转矩阵的形式作用于 2D 二维平面向量子空间
美妙性质:两向量经过 RoPE 旋转后的内积结果,天然只取决于它们的相对位移 (m - n)!绝对位置中蕴含相对位置!
💻 高效工程实现
频率生成:θ_i = 1000000^(-2i/d)
旋转实现:通过 rotate_half 辅助函数高效实现无矩阵乘法的复数向量旋转
外推机制:结合 YaRN / NTK 缩放可无微调直接外推扩展模型上下文窗口长度
第15讲 · GQA 与 KV Cache:推理省钱基石
🐢 推理重复计算之痛
自回归吐字时,若无缓存机制,每生成 1 个新词就要重算前面所有历史词的 K 和 V,计算复杂度呈 O(N^2) 灾难级浪费
💾 KV Cache 机制
把历史 Token 的 K、V 键值对保存在显存中,当前 Step 仅需计算新输入的单个 Token,直接与缓存拼接,计算降为 O(N)
👥 注意力架构横向演进
MHA (Multi-Head):N 个 Q 头对应 N 个 KV 头(显存占用最高)
MQA (Multi-Query):N 个 Q 头共享 1 组 KV 头(极省显存但模型容量下降)
GQA (Grouped-Query):将 Q 头分组,每组共享一组 KV 头(MiniMind 采用 8 个 Q 头分成 2 组或 4 组,兼顾速度与效果)
实现技巧:repeat_kv 函数在计算注意力前对分组 KV 进行维度广播复制
第16讲 · FFN、SwiGLU 与完整的 Transformer Block
🚪 前馈网络 (FFN) 的分工
Attention 负责空间 token 之间的信息交互汇聚,FFN 负责单 token 内部特征通道的知识记忆与非线性推理
💡 SwiGLU 门控前馈机制
公式:SwiGLU(x) = (SiLU(x W_gate) ⊙ x W_up) W_down
引入门控分支作为可学习的非线性开关,表现显著超越传统双层 MLP
🧱 MiniMindBlock 组装全景
Pre-Norm 规范:x = x + Attention(RMSNorm(x))
残差连接:x = x + FFN(RMSNorm(x))
双 RMSNorm + 双残差连接,构成最强健稳定的 Transformer 基本单元
第17讲 · 拼装整台模型:从 Embedding 到 Logits
🏗️ 骨干网络完整链路
输入 Token IDs ➔ tok_embeddings 查找表 ➔ N 个 MiniMindBlock 串联深层堆叠 ➔ 顶层 final_norm ➔ lm_head 线性映射 ➔ Logits [B, S, V]
🔗 权重绑定 (Weight Tying)
将 lm_head.weight 与 tok_embeddings.weight 强制共享同一矩阵
收益:节省数百万参数显存,加速词表嵌入收敛,MiniMind 轻量化核心手段
🎯 错位预测损失 (Shift Loss)
Inputs 取 ids[:, :-1],Targets 取 ids[:, 1:],错开一位计算交叉熵
初始化理论 Loss:未训练时 Loss ≈ ln(vocab_size) = ln(6400) ≈ 8.76(验证模型初始化的试金石)
第18讲 · MoE 混合专家:用更少的算力做更大的模型
🏥 专家分工思想
不使用一个超大的 FFN,而是部署多个相对小型的专家 FFN (Experts),不同 Token 走不同专家
🚦 Router 门控路由网络
用一个小线性层评估每个 Token 与各专家的相关度,选取 Top-K 专家(如 8 选 2),并通过 Softmax 归一化分配加权权重
⚖️ 负载均衡辅助损失 (Auxiliary Loss)
防止路由塌陷:避免部分专家被过度调度而其他专家荒废,强行拉平专家利用率
💻 MiniMind-MoE 代码
在 model_minimind.py 中仅用约 30 行原生 PyTorch 即可实现极简稀疏 MoE 路由架构
第19讲 · 推理与采样:把概率变成生动的回答
🎲 采样算法家族
贪婪解码 (Greedy Search):每次选 argmax 最大概率词,机械死板,极易陷入循环复读
温度调节 (Temperature):Logits / T;T<1 概率分布更陡峭趋于保守确定,T>1 概率平滑激发出奇创想
Top-K 截断:只保留概率最高的 K 个候选词,丢弃其余长尾词
Top-P 核采样 (Nucleus Sampling):按概率从大到小动态累加至阈值 P(如 0.9),自适应候选词范围
🔄 Repetition Penalty (防复读惩罚)
对已生成过的 token 施加 Logits 惩罚因子,彻底消除重复句式
💻 完整自回归生成循环
预填充 (Prefill) 阶段填装 KV Cache ➔ 解码 (Decode) 逐字采样 ➔ 遇到 <|im_end|> 终止符号安全退出
📊 第⑤篇 · 数据工程
第20讲 · 数据是大模型的天花板:三类数据形态
📚 三阶段数据矩阵
预训练数据:海量通用无监督文本(百科、书籍、代码、网络抓取),决定模型的常识储备与语言底蕴
SFT 数据:精炼的高质量问答/指令对话对,决定模型的指令遵循与听话能力
RL/DPO 数据:Prompt + 优质回答 vs 劣质回答偏好对,决定模型的安全对齐与价值观
💎 数据质量 > 数据数量
低质脏数据带来灾难性幻觉与拟合偏差;精心清洗的数百万 Token 效果远胜数十亿原始垃圾语料
📂 MiniMind 真实开源数据集
预训练语料 (约 127 万条高质量短文本) 与 SFT 多轮对话语料 (约 90 万条高质对话)
第21讲 · 数据清洗与去重流水线
🧹 规则过滤流水线
长度阈值过滤、脏字符/控制字符清洗、乱码剔除、HTML 标签反转义、涉政涉黄敏感词过滤
🔍 局部敏感哈希 (SimHash)
将文档分词并按权重累加计算 64 位二进制指纹
通过海明距离 (Hamming Distance ≤ 3) 闪电级判断中短文本相似度,适合中小规模去重
🏭 工业级 MinHash + LSH
基于 Jaccard 相似度的 MinHash 签名,配合 LSH 桶实现超大规模分布式语料 O(N) 极速去重
第22讲 · Dataset 与 DataLoader 工程落地
📦 dataset/lm_dataset.py 解剖
PretrainDataset:连续文本分块,定长截断与拼接
SFTDataset:多轮 ChatML 解析,构造输入与监督目标
📏 截断与 Padding 策略
固定 max_seq_len,过长截断,过短补 pad_token_id,构建 attention_mask
🎭 Label Mask 机制
非计算损失位置(Padding 及 User 提示词)标签统统置为 -100,利用 PyTorch 内置 ignore_index=-100 自动跳过
⚡ 高性能 DataLoader 调优
多进程读取 (num_workers)、锁页内存 (pin_memory=True)、shuffle 打乱防局部过拟合
⚡ 第⑥篇 · 预训练 Pre-training
第23讲 · 预训练目标与困惑度 (PPL)
🎯 下一个词预测 (Next Token Prediction)
无监督自回归任务:最大化条件概率似然 log P(w_t | w_1, ..., w_{t-1})
涌现机理:为了完美猜测下一个词,模型被迫在内部建立语法体系、物理常识、逻辑因果与事实记忆
📉 困惑度 (Perplexity, PPL)
公式:PPL = exp(CrossEntropyLoss)
直观含义:模型在每个位置做选择时平均犹疑不决的备选词数量
收敛轨迹:从最初随机初始化的 PPL=6400 逐渐降低至几十乃至个位数,见证智能诞生的实操过程
第24讲 · 预训练循环逐行拆解与工程巧劲
🔬 train_pretrain.py 逐行精读
混合精度:torch.cuda.amp.autocast(dtype=torch.bfloat16) 节省近半显存
梯度累积:loss = loss / accum_steps ➔ backward() ➔ 达步数后 step() 并 zero_grad()
梯度裁剪:scaler.unscale_(optimizer) 后 clip_grad_norm_(max_norm=1.0),扼杀梯度爆炸于摇篮
⚖️ 精度选型经验
BF16 动态指数位宽与 FP32 完全相同,无溢出风险,现代显卡 (Ampere/Ada/Hopper) 首选;FP16 动态范围小易溢出需谨慎配合 GradScaler
第25讲 · 学习率调度与断点续训机制
📈 余弦衰减学习率曲线
Warmup 阶段:线性预热防止初始大梯度打乱初始随机分布
Cosine 退火:平滑递减至最低约 10% 初始学习率,确保平稳深层收敛
💾 坚固的断点续训体系
Checkpoint 存储全家桶:模型参数 + 优化器状态 + 调度器状态 + 当前 Step/Epoch
SkipBatchSampler:重启训练时自动快速跳过已经训练完的数据批次,无损接续训练现场
💬 第⑦篇 · 监督微调 SFT
第26讲 · 从「续写」到「对话」:指令微调的本质
🗣️ 预训练模型的局限
预训练模型只会漫无边际地接龙续写,给出一个问句往往续写出新的问句,缺乏仆从服务意识
🎓 SFT 的使命注入
通过成千上万条标准「提问-解答」范例,规训模型将接龙能力收敛为解答人类提问
📜 ChatML 多轮模版编排
拼接系统提示词、多轮历史对话,并以 <|im_start|>assistant\n 作为末尾引导词触发模型作答
第27讲 · SFT 的核心秘诀:Loss Mask 精准掩码
🚫 全量 Loss 的毒害
若对 User 提问部分也计算 Loss,模型会浪费大量宝贵容量去记忆提问方式,甚至引发复读与错乱
🎯 精准掩码实现
遍历多轮对话序列,仅在 assistant 对应的区间保留真实 Token 标签,其余 user/system/padding 位置全部填入 -100
PyTorch 交叉熵自动屏蔽 -100,确保梯度 100% 只来自模型生成的内容
第28讲 · 全量微调 vs LoRA:用 1% 的参数学新技能
💸 全量微调的显存代价
微调全部参数需要保存全量梯度与 AdamW 一二阶动量,显存开销通常是模型权重的 4~6 倍
🪄 LoRA 低秩分解魔法 (Low-Rank Adaptation)
原理:冻结预训练基座 W_0,旁路增加两个低秩矩阵 A 和 B:W = W_0 + (α/r) * (B A)
初始化技巧:A 矩阵高斯随机初始化,B 矩阵全 0 初始化,确保初始状态 ΔW = 0,不破坏基座原有能力
参数量大降:训练参数压缩至原模型的 1% 甚至 0.1%,消费级显卡轻松调优
推理无感合并:微调结束后直接将 (α/r) * (B A) 矩阵相加回基座权重,实现零额外延迟推理
第29讲 · 自适应思考 (Reasoning):给模型装上「打草稿」的脑电波
🤔 慢思考 (Slow Thinking) 机制
借鉴 OpenAI o1 与 DeepSeek-R1 范式,强制模型在给出最终答案前在 <think> ... </think> 标签内进行推导与推演
🎛️ 自适应控制开关
通过设置特定的 system 提示词或开关参数 open_thinking,实现「直接回答」与「深度打草稿推理」的双模式切换
📚 思考数据微调实践
引入带有 reasoning_content 的多步骤推理解题数据集进行 SFT 微调,小模型也能呈现惊人的自纠错与严密逻辑链
🎯 第⑧篇 · 对齐与强化学习
第30讲 · RLHF 全景与奖励模型 (Reward Model)
🧭 对齐三原则 (HHH 原则)
Helpful(有用性)、Honest(诚实性)、Harmless(安全性)
🏆 奖励模型原理与训练
架构:将语言模型顶层输出标量打分 r(x, y)
Bradley-Terry 偏好损失:L = -log(σ(r(chosen) - r(rejected))),拉大好回答与差回答之间的得分间距
第31讲 · DPO 直接偏好优化 (Direct Preference Optimization)
⚡ 摆脱复杂奖励模型的革命
斯坦福提出:数学推导证明语言模型自身策略即可隐式代表奖励函数,彻底抛弃独立 Reward Model
📐 DPO 损失公式剖析
L_DPO = -E [ log σ( β * log(π_θ(y_w|x)/π_ref(y_w|x)) - β * log(π_θ(y_l|x)/π_ref(y_l|x)) ) ]
β 参数作用:调节偏离参考模型 π_ref 的保守程度,防止策略崩塌
💻 实战体验:train_dpo.py
只需一份偏好数据集,优雅稳定地完成对齐优化,训练难度大幅降低
第32讲 · 强化学习基础:策略梯度、Actor-Critic 与 GAE
🎲 强化学习四大要素
状态 S (提示词与历史)、动作 A (生成的 Token)、奖励 R (最终得分)、策略 π (大模型概率分布)
📈 策略梯度算法 (Policy Gradient)
∇J(θ) = E [ ∇log π_θ(a|s) * R ]:做对了就提升对应 token 的生成概率,做错了就压低概率
🎭 Actor-Critic 架构
Actor (生成者):负责吐字生成答案;Critic (评论家):负责评估当前局部状态的长期期望价值 V(s)
📊 广义优势估计 (GAE)
平衡偏差与方差,计算每个时间步的相对超额回报 A_t
第33讲 · 从零实现 PPO (Proximal Policy Optimization)
🤝 四个模型协同作战
1. Actor Model (训练中的策略模型)
2. Critic Model (状态价值评估模型)
3. Reference Model (冻结的参考 SFT 模型,提供 KL 惩罚)
4. Reward Model (冻结的偏好打分模型)
✂️ PPO 核心裁剪损失 (Clipped Loss)
L_clip = min( ratio * A, clip(ratio, 1-ε, 1+ε) * A )
哲学:小步慢走,严格限制单次策略更新幅度,杜绝参数走崩
🎯 损失三合一
策略裁剪损失 + 价值拟合损失 (Value Loss) + KL 散度约束(防止模型丧失基础语言能力)
第34讲 · GRPO 与 CISPO:砍掉 Critic 的群体相对策略优化
🚀 DeepSeek-R1 爆款核心算法
彻底砍掉体积庞大的 Critic 评论家网络,大幅降低显存占用与显存碎片!
💡 群体相对优势计算 (Group Relative)
针对同一个 Prompt,采样生成 G 个不同回答候选 {y_1, y_2, ..., y_G}
计算这组回答的奖励评分,直接在组内做标准化:A_i = (r_i - mean(r)) / (std(r) + ε)
以组内相对高下作为优势,无需训练价值模型
🛡️ k3 估计法精算 KL 散度
更优的 KL 散度数值估计方案,算法极其精简高效
第35讲 · Rollout 采样引擎解耦与落地
⏳ RL 核心瓶颈:生成等待
RL 训练耗时超 80% 阻塞在采样生成环节
🧩 RolloutEngine 解耦架构
统一抽象基类,支持原生 PyTorch 推理与高性能 vLLM 采样切换
输出标准张量:生成的 tokens、序列 mask、逐 token 对应 logprob 概率值,并周期性同步最新模型权重
🤖 第⑨篇 · Agent 与应用
第36讲 · 工具调用 (Tool Use / Function Calling)
🛠️ 走出纯文本孤岛
让模型借助外部计算器、网页搜索、数据库执行等解决自身数学精度差与即时信息缺失问题
📦 结构化调用协议
在 system 中传入 JSON Schema 描述的工具函数列表
模型通过约定标签包裹工具入参:<tools>{"name": "func", "arguments": {...}}</tools>
🔄 闭环调用流
模型吐出调用标签 ➔ 拦截并执行真实 Python 函数 ➔ 以 tool 角色回填结果 ➔ 模型总结输出终版自然语言回答
第37讲 · Agentic RL:多轮智能体强化学习
🤖 复杂长链条交互任务
多步自主规划、根据环境反馈反复调试纠错,直至任务达成
🔁 多轮交互 Rollout 树
生成 ➔ 执行工具 ➔ 环境状态改变 ➔ 接收 Observation ➔ 产生下一步动作
🎖️ 复合奖励设计
格式合规奖励 + 步骤有效性奖励 + 最终目标解决成功奖励 + 步骤惩罚(鼓励最高效解决)
第38讲 · 知识蒸馏 (Knowledge Distillation)
👨🏫 师徒传承模式
让大模型 (Teacher, 如 70B/14B) 作为导师,指导训练小模型 (Student, 如 MiniMind 64M)
🌡️ 软标签 (Soft Labels) 与暗知识
硬标签只有 0 和 1;高温 T 软化后的概率分布展现了深层语义相似度(如猫与狗的相关度高于猫与汽车)
📐 联合蒸馏损失
总损失 = (1-α) * 真实标签交叉熵 + α * T^2 * 师生分布 KL 散度,助小模型越级吸收大模型精华
🚀 第⑩篇 · 部署、评测与进阶
第39讲 · 模型转换与高性能推理服务
🔄 权重格式标准化与轻量化
convert_model.py:从 PyTorch .pth 导出为标准 Hugging Face SafeTensors 格式
格式转换:支持转换为 GGUF / ONNX,配合 llama.cpp 实现手机端侧与 CPU 极速量化推理
🌐 工业标准 API 服务化
基于 FastAPI 搭建 serve_openai_api.py,兼容 /v1/chat/completions 标准接口
无缝接入 NextChat、ChatBox、Open-WebUI 等全网流行 AI 客户端工具
第40讲 · 大模型评测体系全景
📏 评测三把尺子
1. 基础语言建模能力:测试集困惑度 PPL(越低越流畅)
2. 综合学科基准测试:C-Eval / CMMLU(中文学科)、MMLU(英文综合)、GSM8K(多步数学)、HumanEval(代码生成)
3. 系统推理吞吐:TTFT (首字生成延迟) 与 Throughput (每秒生成 Token 数)
⚠️ 评测避坑指南
警惕 Benchmark 测试集数据污染 (Data Contamination);严谨设置统一的 Temperature 与 Few-shot 评测模版
第41讲 · 做出你的 Web Demo:从代码到交互应用
💻 可视化应用落地
web_demo.py:基于 Streamlit / Gradio 搭建现代化多轮聊天 Web 界面
⚡ 流式打字机效果实现
TextIteratorStreamer 异步线程后台生成,前台通过 SSE (Server-Sent Events) 即时逐字推流,体验丝滑流畅
💾 会话状态管理
Session 历史上下文滑动窗口管理,超出模型 max_seq_len 自动裁剪早前对话
第42讲 · 总结与进阶:从 MiniMind 走向真实千亿大模型
📈 Scaling Law 缩放定律
损失与计算量 C、数据规模 D、参数量 N 遵循精准幂律定律 (Power Law)
Chinchilla 黄金平衡配比:参数增加与数据增加保持等比协同缩放
🚀 工业级分布式扩展技术
分布式并行范式:数据并行 (DDP / FSDP / ZeRO-1/2/3)、张量并行 (TP, Megatron-LM)、流水线并行 (PP)
极限算子优化:FlashAttention-1/2/3 IO 感知显存分块计算、PagedAttention 解决显存碎片化
🎓 全书技术终局总结
亲手手写一遍 42 讲全流程代码,彻底脱离大模型黑盒困境,获得通往工业级前沿大模型底层的金钥匙!
Collect
Get Started
Collect
Get Started
Collect
Get Started
Collect
Get Started
评论
0 条评论
下一页